【论文解读】ZeRO
Categories: Paper
目录
- 概览
- 一、引言
- 二、训练显存去了哪里
- 三、ZeRO 的核心洞察与总览
- 四、ZeRO-DP:模型状态三阶段分片
- 五、ZeRO-R:Residual-state 优化
- 六、ZeRO-DP 通信量分析
- 七、ZeRO-R 通信量分析
- 八、总结
概览
本文提出 Zero Redundancy Optimizer(ZeRO),目标是在保持数据并行计算粒度和较低通信量的同时,消除训练过程中重复存储的模型状态。ZeRO 将训练显存分为两类:参数、梯度和优化器状态构成 model states;activation、临时 buffer 与内存碎片构成 residual states。ZeRO-DP 处理前者,ZeRO-R 处理后者。
ZeRO-DP 按三个阶段依次分片优化器状态、梯度和参数。对于包含 $\Psi$ 个参数、数据并行度为 $N_d$ 的混合精度 Adam 训练,model-state 显存从标准数据并行的 $16\Psi$ bytes,依次降至近似 $4\Psi$、$2\Psi$ 和 $16\Psi/N_d$ bytes。前两个阶段的通信量与标准数据并行相同;参数分片阶段将通信量增加到 $1.5$ 倍,却使每设备模型状态显存随 $N_d$ 线性下降。
原文链接:ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
一、引言
深度学习模型正在持续增大,模型规模增长通常能够带来显著的准确率提升。若要继续把规模从数百亿参数扩展到万亿参数,首先必须解决训练问题:这些模型无法放入单个 GPU 或 TPU 的内存,而简单增加设备数量并不能自动扩大可训练模型。
基础数据并行不会减少每台设备的显存占用。在配备 32GB 显存的当代 GPU 上,标准数据并行训练超过约 1.4B 参数的模型就会耗尽内存。Pipeline Parallelism、Model Parallelism 和 CPU offloading 会在功能、易用性、内存效率、计算效率与通信效率之间做不同取舍,而大规模快速训练需要同时满足这些条件。
模型并行是当时训练最大模型的主要方案,模型并行沿垂直方向切分模型,将每层中的计算和参数划分到多个设备上,需要每层之间进行大量通信。它在单节点内表现良好,但跨节点后效率会迅速下降。使用 Megatron-LM 在两个 DGX-2 节点上训练 40B 模型时,每张 V100 只达到约 5 TFLOPs,不到硬件峰值的 $5\%$。
模型训练时,可将显存划分为两部分:
- model states:包括优化器状态,例如 Adam 的 momentum 和 variance,以及 gradients 与 parameters;
- residual states:activations、temporary buffers 和由于碎片化而无法使用的显存。
ZeRO 分别优化这两部分,同时维持计算和通信效率。
(一)优化 model-state 显存
数据并行具有良好的计算和通信效率,却在每个 data-parallel process 上复制全部模型状态。模型并行通过分片模型状态提高内存效率,但会缩小计算粒度并增加通信。二者还会在整个训练过程中静态保存所有模型状态,尽管某些状态只在特定时刻需要;例如,一层的参数只在该层执行 forward 或 backward 时需要。
ZeRO-powered data parallelism(ZeRO-DP)不再复制 model states,而是在 data-parallel processes 之间分片 optimizer states、gradients 和 parameters。训练期间使用动态通信调度,在需要状态时临时取回,从而保留数据并行的计算粒度与通信量。
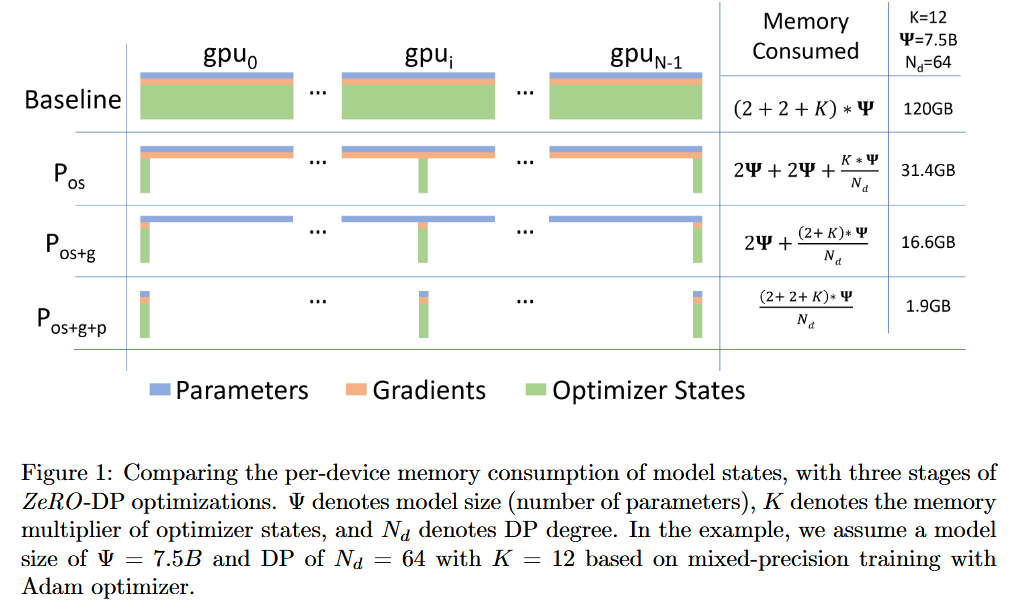
ZeRO-DP 具有三个优化阶段,三个阶段累计启用:
- Optimizer State Partitioning,记为 $P_{os}$:model-state 显存最多降低约 $4\times$,通信量与标准 DP 相同;
- 再加入 Gradient Partitioning,记为 $P_{os+g}$:model-state 显存最多降低约 $8\times$,通信量仍与标准 DP 相同;
- 再加入 Parameter Partitioning,记为 $P_{os+g+p}$:model-state 显存降低倍数与数据并行度 $N_d$ 成正比,通信量最多增加 $50\%$。
ZeRO-DP 消除了显存占用冗余,使得一个集群的全部聚合显存容量更好的被利用。若同时开启三个阶段,ZeRO 可以在 1024 个 Nvidia GPU 上训练 1T 参数的模型。在 16-bit 精度下,1T 参数模型若使用 Adam 进行训练,parameters、gradients 和 optimizer states 总计约需 16TB。若在 1024 个 data-parallel processes 间完整分片,每个 process 只需约 16GB model-state 显存。
(二)优化 residual-state 显存
当 ZeRO-DP 大幅降低 model states 后,activations、temporary buffers 和 memory fragments 会成为新的瓶颈。ZeRO-R 分别处理三者:
- activation checkpointing 本身不足以支撑极大模型;ZeRO-R 将模型并行中重复保存的 activation checkpoints 分片,必要时还可 offload 到 CPU;
- 临时 buffer 使用与模型大小无关、但足以维持算子效率的固定容量;
- 根据 tensor 生命周期主动管理连续内存,避免碎片化导致总空闲显存足够但找不到连续块的分配失败。
ZeRO-DP 和 ZeRO-R 组合在一起形成了一个强大的深度学习训练显存优化系统,统称为 ZeRO。
(三)ZeRO 与模型并行
仅为让模型放入显存而使用模型并行时,ZeRO-DP 至少能提供相同的单设备显存缩减,并通常具有相当或更好的扩展效率。数据并行还不要求模型开发者重写模型或实现分布式算子。
模型并行仍有两种用途。第一,配合 ZeRO-R 时,它可以进一步缩小极大模型的 activation memory。第二,当仅使用数据并行会使 global batch 超过有利于收敛的临界 batch size 时,可以加入模型并行,使模型在可接受的总 batch 下运行。
当数据并行度为 $N_d$、模型并行度为 $N_m$ 时,二者组合的理论单设备显存缩减可达到:
\[\begin{equation} N_d N_m \end{equation}\]例如,在 1024 张 GPU 上使用节点内 16 路模型并行与跨节点 64 路数据并行,可以使 1T 参数模型的状态放入设备内存,并保持适中的 batch size。
二、训练显存去了哪里
1.5B 参数 GPT-2 的 FP16 权重只占约 3GB,却无法使用 TensorFlow 或 PyTorch 在单张 32GB GPU 上训练。人们不禁会疑惑,这些显存究竟消耗在了哪里。模型训练过程中,绝大部分显存被模型状态占用,也就是由优化器状态、梯度以及参数构成的张量。除了这些模型状态之外,剩余显存被激活值、临时缓冲区以及显存碎片所占用,我们将其统称为残余状态。接下来我们将从这两方面详细分析内存占用情况。
(一)模型状态:优化器状态、梯度以及参数
Adam 为每个参数保存两个优化器状态:梯度的一阶动量和二阶方差。训练还必须保存参数本身及对应梯度。混合精度训练进一步保留 FP32 master parameters 与 FP32 optimizer states。设模型参数数量为 $\Psi$,混合精度 Adam 的显存账本为:
| 状态 | 精度 | 每参数字节 | 总显存 |
|---|---|---|---|
| Forward/backward parameters | FP16 | 2 | $2\Psi$ |
| Gradients | FP16 | 2 | $2\Psi$ |
| Master parameters | FP32 | 4 | $4\Psi$ |
| Momentum | FP32 | 4 | $4\Psi$ |
| Variance | FP32 | 4 | $4\Psi$ |
令 $K$ 表示 optimizer states 的每参数字节乘数,混合精度 Adam 中:
\[\begin{equation} K=4+4+4=12 \end{equation}\]全部 model-state 显存为:
\[\begin{equation} M_{\mathrm{DP} } =2\Psi+2\Psi+K\Psi =(4+K)\Psi =16\Psi\ \mathrm{bytes} \label{eq:baseline-memory} \end{equation}\]因此,1.5B 参数模型至少需要:
\[\begin{equation} 16\times1.5\times10^9 =24\times10^9\ \mathrm{bytes} \approx24\ \mathrm{GB} \end{equation}\]而不仅是 FP16 权重占用的 3GB。
(二)残余状态
中间激活可以占据大量显存。序列长度 1024、batch size 32 的 1.5B GPT-2,未经优化的 activation 约需 60GB。Activation checkpointing 是一种常用的优化方法,该方法以约 $33\%$ 的重算开销,将 activation memory 近似降低到原规模的平方根量级,该模型采用该技术后,激活内存占用可降至约 8GB。即使使用 checkpointing,100B GPT-like 模型在相同 batch 和序列长度下仍可能需要约 60GB activation memory。
用于存储中间结果的临时缓冲区会为大模型消耗可观的显存。大型训练算子常把 tensor 融合进连续临时 buffer。例如 gradient all-reduce 和 gradient norm 会把 gradients 展平,以通过更大的消息获得更高带宽。1.5B 参数模型的 FP32 flattened buffer 单独就需要 6GB。
内存碎片还可能使分配在总空闲显存充足时失败。若没有足够大的连续区域,分配请求仍会 OOM,极端的大模型训练中,剩余显存超过 $30\%$ 时也可能出现这种情况。
三、ZeRO 的核心洞察与总览
(一)ZeRO-DP
ZeRO-DP 建立在三项事实之上:
- 数据并行拥有更大的计算粒度和更低通信量,因此通常比细粒度模型并行更容易扩展;
- 数据并行在所有进程上重复保存全部 model states,内存效率低;模型并行则通过分片这些状态获得内存效率;
- 参数和梯度并非在训练步骤的每个时刻都需要完整存在。例如,某一层对应的参数仅在该层前向传播与反向传播阶段才会被调用。
ZeRO-DP 将 model states 分片,并根据其时间生命周期动态通信。单设备 model-state 显存随 $N_d$ 增大而线性下降,通信量则保持接近标准 DP。
(二)ZeRO-R
模型并行虽然分片模型状态,但通常需要复制激活内存。例如将一个线性层的参数按列切到两张 GPU 后,每张 GPU 仍需要完整输入 activation 来计算自己的参数分片。对于 GPT-2 规模及以上模型具有很高的计算强度,且随隐藏维度呈线性增长,即便带宽较低,也能够掩盖激活检查点的数据迁移开销。ZeRO 通过在多块 GPU 之间对激活检查点进行分片,消除了模型并行中的显存冗余,并借助 all-gather 操作按需还原激活检查点。激活显存占用的降低幅度与模型并行度成正比。针对超大规模模型,ZeRO 还可选择将激活分片迁移至 CPU 内存;得益于这类模型具备很高的运算强度,依然可以实现不错的运行效率。
ZeRO‑R 使用大小固定的缓冲区,避免临时缓冲区随模型规模增大而过度膨胀,同时将缓冲区设置得足够大,以保证运行效率。
显存碎片是短期存活显存对象与长期存活显存对象交错分布所导致的结果。前向传播过程中,激活检查点属于长期存活对象,而重新计算得到的激活值则为短期存活对象。与之类似,在反向计算阶段,激活梯度是短期存活对象,参数梯度则为长期存活对象。基于这一认知,ZeRO 通过将激活检查点与梯度迁移至预分配的连续显存缓冲区,实现实时显存碎片整理。该操作不仅提升可用显存容量,还能减少显存分配器查找空闲连续显存的耗时,进而提升运行效率。
四、ZeRO-DP:模型状态三阶段分片
标准 DP 在每张设备复制 optimizer states、gradients 和 parameters。ZeRO-DP 依次移除三类冗余。
记号如下:
- $\Psi$:模型参数数量;
- $K$:optimizer states 的每参数字节数,混合精度 Adam 中 $K=12$;
- $N_d$:数据并行度。
(一)阶段一:Optimizer State Partitioning,$P_{os}$
将 optimizer states 分为 $N_d$ 个等大 partitions。第 $i$ 个 data-parallel process 只保存并更新第 $i$ 个 partition 对应的 optimizer states,也只负责更新 $1/N_d$ 的参数。每个训练 step 结束时,通过 all-gather 收集各 process 更新后的参数分片,使每个 process 再次得到完整参数。
FP16 parameters 和 FP16 gradients 仍在每个 process 完整保存,各占 $2\Psi$ bytes;只有 optimizer states 被分片:
\[\begin{equation} \begin{aligned} M_{P_{os} } &=2\Psi+2\Psi+\frac{K\Psi}{N_d}\\ &=4\Psi+\frac{K\Psi}{N_d} \end{aligned} \label{eq:pos-memory} \end{equation}\]当 $K=12$ 且 $N_d$ 很大时:
\[\begin{equation} M_{P_{os} }\approx4\Psi \end{equation}\]相对标准 DP 的 $16\Psi$ 最多减少约 $4\times$。在 $\Psi=7.5$B、$N_d=64$ 时,model states 从 120GB 降至 31.4GB。
(二)阶段二:Gradient Partitioning,$P_{os+g}$
每个 process 只更新自己的参数 partition,因此也只需要该 partition 的 reduced gradients。Backward 中每层 gradient 一旦产生,就把它 reduce 到负责相应参数的 process;reduce 完成后,其他 process 不再保存该 gradient,可立即释放内存。
该过程等价于 Reduce-Scatter:不同参数的 reduced gradients 被分配到不同 processes。实际实现按 partition 将 gradients bucketize,在 partition boundary 对整个 bucket 做 reduction,以提高通信带宽并与 backward computation 重叠。
parameters 仍完整复制,占 $2\Psi$;gradients 与 optimizer states 都被分片:
\[\begin{equation} \begin{aligned} M_{P_{os+g} } &=2\Psi+\frac{2\Psi}{N_d}+\frac{K\Psi}{N_d}\\ &=2\Psi+\frac{(2+K)\Psi}{N_d} \end{aligned} \label{eq:posg-memory} \end{equation}\]混合精度 Adam 中 $2+K=14$:
\[\begin{equation} M_{P_{os+g} } =2\Psi+\frac{14\Psi}{N_d} \approx2\Psi \quad(N_d\ \text{较大}) \end{equation}\]相对 $16\Psi$ 最多减少约 $8\times$。在 7.5B 参数、64-way DP 中,model-state 显存为 16.6GB。
(三)阶段三:Parameter Partitioning,$P_{os+g+p}$
每个 process 进一步只保存自己负责的 parameter partition。Forward 或 backward 需要其他 partition 时,由拥有该分片的 process broadcast/all-gather;该层计算完成后立即丢弃临时完整参数。
parameters、gradients 和 optimizer states 全部分片:
\[\begin{equation} \begin{aligned} M_{P_{os+g+p} } &=\frac{2\Psi}{N_d} +\frac{2\Psi}{N_d} +\frac{K\Psi}{N_d}\\ &=\frac{(4+K)\Psi}{N_d} =\frac{16\Psi}{N_d} \end{aligned} \label{eq:stage3-memory} \end{equation}\]单设备 model-state 显存因而随 $N_d$ 线性下降。7.5B 参数、64-way DP 时只需约 1.88GB,而标准 DP 为 120GB。
(四)对模型规模的含义
三个累计阶段相对标准 DP 的最大 model-state 显存缩减分别约为:
\[\begin{equation} 4\times,\qquad8\times,\qquad N_d\times \end{equation}\]在 32GB V100 上,$N_d=64$ 时,$P_{os}$、$P_{os+g}$、$P_{os+g+p}$ 分别可容纳约 7.5B、14B 和 128B 参数。$N_d=1024$ 且启用全部分片时,1T 参数的 model-state 显存为:
\[\begin{equation} \frac{16\times10^{12} }{1024} \approx15.6\ \mathrm{GB/device} \end{equation}\]当然,该结论表示模型状态可以放入设备,不等于已经具有在合理时间内完成 1T 模型训练所需的总计算能力。
五、ZeRO-R:Residual-state 优化
(一)Partitioned Activation Checkpointing,$P_a$
模型并行通常在各 model-parallel processes 上复制 activation。$P_a$ 在一层 forward 完成后,把该层输入 activation 分片并只保存各自 partition;backward 重算需要该 activation 时,通过 all-gather 临时恢复完整副本。使用后,完整副本再次释放。
$P_a$ 与 activation checkpointing 联合使用,保存的是分片 checkpoint 而不是分片全部 activation。设备显存极为有限时,还可以把分片 checkpoint offload 到 CPU,记为 $P_{a+cpu}$。
100B 模型、batch size 32、sequence length 1024、model parallel degree 16 时,每个 Transformer layer 保存一个完整 activation checkpoint 约需每 GPU 33GB。$P_a$ 将其降低到约 2GB;继续 offload 到 CPU 后,device activation-checkpoint 显存接近 0。
(二)Constant Size Buffers,$C_B$
一些训练操作的效率高度依赖输入大小;大 all-reduce 通常比小 all-reduce 获得更高带宽。Apex 与 Megatron 会把所有参数或 gradients 融合进一个大 buffer 后执行操作,但该 buffer 大小随模型增长。3B 参数模型的 FP32 fused buffer 可达 12GB。
$C_B$ 在模型变大时使用固定容量的 fused buffer。容量足以维持算子效率,却不再与模型参数量成比例增长。
(三)Memory Defragmentation,$M_D$
Activation checkpointing 会使 forward 中的长寿命 checkpoint 与可丢弃、可重算的短寿命 activation 交错。Backward 中,parameter gradients 是长寿命对象,activation gradients 与中间 buffer 是短寿命对象。两类生命周期交错会产生碎片。
$M_D$ 为 activation checkpoints 和 gradients 预先分配连续内存,并在 tensor 产生时复制到对应区域。这样既避免因缺少连续块而 OOM,也减少 allocator 搜索连续空间的开销。
六、ZeRO-DP 通信量分析
(一)标准数据并行
在数据并行训练过程中,反向传播结束后、计算下一步参数更新之前,会对所有数据并行进程的梯度做平均处理。该平均操作通过 all-reduce 集合通信原语完成。当模型规模较大时,all-reduce 通信完全受通信带宽约束,因此我们的分析仅聚焦于各个数据并行进程收发的总通信数据量。
高效 all-reduce 可分解为:
- Reduce-Scatter:每个 process 负责一部分数据的 reduce;
- All-Gather:所有 processes 收集全部 reduce 结果。
对包含 $\Psi$ 个元素的 gradients,假设 $N_d$ 为 Data Parallel GPU 数量。Ring Reduce-Scatter 一共需要 $N_d-1$ 轮,每一轮,每张 GPU 发送一个大小为 $\Psi/N_d$ 的 chunk,所以每张 GPU 总共发送: \(\begin{equation} (N_d-1) \frac{\Psi}{N_d} = \frac{N_d-1}{N_d} \Psi \end{equation}\) 当 $N_d$ 很大时,通信量约为 $\Psi$。Reduce-Scatter 结束后,每张卡只有 $\Psi/N_d$,Ring All-Gather 同样需要 $N_d−1$ 轮,每轮发送 $\Psi/N_d$,同样,当 $N_d$ 很大时,通信量约为 $\Psi$。因此,两个步骤分别移动约 $\Psi$ 个元素,每训练 step 的通信量为: \(\begin{equation} V_{\mathrm{DP} }=\Psi+\Psi=2\Psi \label{eq:dp-comm} \end{equation}\)
(二)$P_{os+g}$ 的通信量
采用梯度分区时,每个进程仅存储更新其对应参数分区所需的那部分梯度。同样设:$N_d$ 为 GPU 数量,$\Psi$ 为整个模型参数/梯度的元素总数,这里参数量和梯度量都是 $\Psi$,因为每个参数对应一个梯度。例如,假设 4 张 GPU,模型只有 8 个参数:
参数:
[p0 p1 | p2 p3 | p4 p5 | p6 p7]

GPU0 负责 p0,p1
GPU1 负责 p2,p3
GPU2 负责 p4,p5
GPU3 负责 p6,p7
对于普通 DP,每张 GPU 都有完整模型,并根据自己的 batch 算出完整的 8 个梯度:
GPU0: [g00 g01 g02 g03 g04 g05 g06 g07]
GPU1: [g10 g11 g12 g13 g14 g15 g16 g17]
GPU2: [...]
GPU3: [...]
然后执行 All-Reduce。我们上一轮已经知道 all-reduce = reduce-scatter + all-gather,通信量约为 $2 \Psi$。All-Reduce 完成以后,每张 GPU 都有完整的 averaged gradient:
GPU0: [G0 G1 G2 G3 G4 G5 G6 G7]
GPU1: [G0 G1 G2 G3 G4 G5 G6 G7]
GPU2: [G0 G1 G2 G3 G4 G5 G6 G7]
GPU3: [G0 G1 G2 G3 G4 G5 G6 G7]
其实这里有一个浪费,GPU0 明明只负责更新 p0,p1,但还需要保存 G2~G7。$P_{os+g}$ 不再做完整的 All-Reduce,而是只做 Reduce-Scatter,于是梯度 Reduce 完之后直接分片:
GPU0: [G0 G1]
GPU1: [G2 G3]
GPU2: [G4 G5]
GPU3: [G6 G7]
正好:
GPU0 负责 p0,p1 → 只需要 G0,G1
GPU1 负责 p2,p3 → 只需要 G2,G3
...
所以每张 GPU 不再保存完整 $\Psi$ 个梯度,只保存 $\Psi/N_d$,而 Reduce-Scatter 的通信量约 $\Psi$。每张 GPU 只更新自己负责的参数,接下来:
GPU0:
p0,p1 ← optimizer(p0,p1,G0,G1)

GPU1:
p2,p3 ← optimizer(p2,p3,G2,G3)

GPU2:
p4,p5 ← ...

GPU3:
p6,p7 ← ...
所以更新结束后:
GPU0 有最新的 [p0' p1']
GPU1 有最新的 [p2' p3']
GPU2 有最新的 [p4' p5']
GPU3 有最新的 [p6' p7']
下一轮 forward 每张 GPU 仍然需要完整模型:
[p0' p1' p2' p3' p4' p5' p6' p7']
所以需要一次 All-Gather:
GPU0: [p0' p1'] ─┐
GPU1: [p2' p3'] ─┤
GPU2: [p4' p5'] ─┼→ All-Gather
GPU3: [p6' p7'] ─┘
最后:
GPU0: [p0' ... p7']
GPU1: [p0' ... p7']
GPU2: [p0' ... p7']
GPU3: [p0' ... p7']
All-Gather 通信量又约 $\Psi$,所以总通信量还是 $2\Psi$,即: \(\begin{equation} V_{P_{os+g} } =\underbrace{\Psi}_{\text{gradient reduce-scatter} } +\underbrace{\Psi}_{\text{updated parameter all-gather} } =2\Psi \end{equation}\)
它与标准 DP 完全相同,却最多减少约 $8\times$ model-state 显存。
(三)$P_{os+g+p}$ 的通信量
Parameter partitioning 后,每个 process 只常驻 $\Psi/N_d$ 的参数。在前向传播阶段,每个进程需要接收来自其他所有分片的参数,不过可以通过流水线方式处理,以此规避内存开销。在计算某一分片对应的模型部分的前向传播之前,负责该分片的数据并行进程可以将权重广播至全部数据并行进程。该分片的前向传播计算完成后,即可丢弃对应参数。整个 forward 必须把所有这些参数依次通信一次,因此通信量为 $\Psi$。同样的,backward 时,以逆序再执行一次,仍为 $\Psi$。最后还有 Gradient Reduce-Scatter,每张 GPU 用自己的 data batch 算出了梯度贡献,但每个 GPU 最终只负责自己那部分参数,所以梯度也不需要完整 All-Reduce,通信量为 $\Psi$。最终通信量为:
\[\begin{equation} \begin{aligned} V_{P_{os+g+p} } &=\underbrace{\Psi}_{\text{forward parameters} } +\underbrace{\Psi}_{\text{backward parameters} } +\underbrace{\Psi}_{\text{gradient reduce-scatter} }\\ &=3\Psi \end{aligned} \end{equation}\]相对标准 DP:
\[\begin{equation} \frac{3\Psi}{2\Psi}=1.5. \end{equation}\]因此 Stage 3 以最多 $50\%$ 的通信量增加,换取随 $N_d$ 线性下降的 model-state 显存。
七、ZeRO-R 通信量分析
将 ZeRO-R 中的分片式激活检查点 $P_a$ 的通信量,与基线模型并行进行比较。结果表明,$P_a$ 所增加的通信量,通常不到基线 MP 通信量的十分之一。以使用 Megatron-LM model parallelism 的 Transformer 为例,每个 Transformer block 在 forward 执行 2 次 all-reduce,在 backward 的 forward recomputation 执行 2 次,在 backward 本身再执行 2 次。每次 All-Reduce 的消息大小为: \(\begin{equation} B\times T\times H \end{equation}\)
其中 $B$ 是 batch size,$T$ 是 sequence length,$H$ 是 hidden dimension。一次 all-reduce 的通信 volume 为消息大小的 2 倍,因此每 block 的 model-parallel communication 为:
\[\begin{equation} V_{\mathrm{MP} } =12BTH \end{equation}\]$P_a$ 在 backward 重算每个 activation checkpoint 前增加一次 all-gather,其通信量约为:
\[\begin{equation} V_{P_a}=BTH \end{equation}\]因此,新增通信不足原 model-parallel communication 的十分之一。
$P_a$ 将 activation memory 按 model parallel degree 缩小,因此允许相应增大倍率的 batch。设 $M_d$ 为模型并行度,一个 activation checkpoint 大小大约是 $BTH$,启用 $P_a$ 后,每张 GPU 只保存 $BTH/M_d$,相应的,batch size 如果增大 $M_d$ 倍,则每张 GPU 保存为 $M_d BTH/M_d = BTH$,即相应的可使用 $M_d$ 倍的 batch size 从而达到与开启 $P_a$ 前相同的显存占用。因此,DP communication 按每样本或固定训练数据量计会随 batch 增大而减少;16-way MP 最多允许约 $16\times$ 的 batch 增长,从而可能使 data-parallel communication 降低一个数量级,而只增加不到 $10\%$ 的 model-parallel communication。
最后,如果使用 $P_{a+cpu}$,那么已经分片的 activation checkpoints 还会进一步被 offload 到 CPU。这样 activation 的 GPU 显存占用可以降低到接近 0。代价是 $P_{a+cpu}$ 相对 $P_a$ 还会增加 activation partition 到 CPU 和返回 GPU 的双向数据移动。在一些极端场景下,即使使用 $P_a$,由于 batch size 仍然很小,DP 通信依然可能成为主要瓶颈。这时,$P_{a+cpu}$ 可以通过进一步释放 GPU 显存、增大 batch size 来提高训练效率。只要满足:CPU 数据传输额外开销 < 减少的 DP 通信开销,那么这样做就是值得的。
八、总结
ZeRO 的核心思想如下:
- 标准 DP 的 model states 在每个 process 完整复制,混合精度 Adam 因而需要 $16\Psi$ bytes;
- $P_{os}$ 只分片 optimizer states,将显存降为 $4\Psi+K\Psi/N_d$;
- $P_{os+g}$ 再分片 gradients,将显存降为 $2\Psi+(2+K)\Psi/N_d$,通信仍为 $2\Psi$;
- $P_{os+g+p}$ 再按需收集 parameters,将显存降为 $(4+K)\Psi/N_d$,通信增至 $3\Psi$;
- ZeRO-R 对 activation checkpoints、temporary buffers 和 fragmented memory 进行分片、限长与主动整理。