【论文解读】SAO
Categories: Paper
目录
概览
大语言模型(LLM)的发展正在从监督式预训练(supervised pre-training)逐渐转向后训练强化学习(post-training RL)。近期强化学习领域的研究表明,同时扩大 RL 阶段的计算量(RL compute)和测试时计算量(test-time compute),是一种非常有效的提升模型智能水平的方法。
目前大多数 LLM 强化学习 pipeline 仍然采用同步(synchronous)且交错式(interleaved)的方式运行:Policy 首先生成一整个 batch 的 rollout,只有等到这个 batch 中的所有 rollout 都采样完成之后,才开始进行模型优化。对于 Agent 和 Coding 任务来说,不同 rollout 的长度差异通常非常大。因此,短轨迹可能很快就生成结束,而较长的轨迹则会成为 straggler(拖尾任务)。结果就是:集群中的大量 GPU 必须闲置,等待最慢的 rollout 完成。异步强化学习(Asynchronous RL)通过持续接收已经生成完成的 rollout,并立即利用这些 rollout 进行训练,可以缓解这种生成阶段负载不均衡的问题,从而提高 GPU 利用率以及整体的 wall-clock efficiency。
但是,异步训练本身会引入两个新的挑战。第一个问题是 off-policy。一条 trajectory 在生成过程中,可能对应于 rollout model 的多个不同版本。这会导致更加不可预测、也更加严重的 off-policy 问题,进而损害训练稳定性。此前已经有一些工作尝试进行异步 RL,但这些工作主要关注的是系统效率优化,而不是训练效果和训练稳定性。第二个问题是 GRPO 这类 group-wise 方法本身并不适合异步训练。GRPO 对于每一个 prompt,会采样一组 responses,然后利用这组 response 的整体统计量,例如组内平均 reward,来进行 advantage estimation。但是,这种 group-wise sampling 会引入一种由延迟导致的 off-policy 问题:一组 rollout 必须等待其中最慢的那条 rollout 完成,才能一起送入训练。因此,即使整个系统已经异步化,GRPO 的 group 内部仍然存在一个隐式的同步点。除此之外,group-wise sampling 也很难应用于真正的在线学习或者复杂的 Agent 环境,因为现实中的环境往往对于一个 prompt 只提供一条 trajectory 的反馈,而不是一次提供一组 trajectory。
本文提出了用于 Agentic RL 的 Single-rollout Asynchronous Optimization(SAO,单轨迹异步优化)。SAO 的目标是:在存在 policy lag(策略滞后) 的异步 RL 环境下,仍然保持训练稳定性和有效性,同时保留异步训练带来的效率优势。与 GRPO 的 group-wise sampling 不同,SAO 使用 single-rollout update:一个 prompt 只采样一条 rollout。
原文链接:Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning
一、预备知识
在语言模型的 RL 中,模型由参数 $\theta$ 参数化为一个随机策略 $\pi_\theta (y | q)$。给定来自数据集 $\mathcal D$ 的一个 query $q$,策略会生成一个 response 序列 $y=[y_1,\dots,y_{|y|}]$。
其中:
- $q$:输入问题 / prompt
- $y$:模型完整输出
- $y_t$:输出的第 $t$ 个 token
- $|y|$:response 的 token 数量
强化学习通过最大化一个 clipped surrogate objective(裁剪代理目标)来优化 $\pi_\theta$,从而使 policy 更新更加稳定。对于一个 batch 的数据,优化目标可以表示为: \(\begin{equation} \mathbb{E} \left[ \frac{1}{|y|} \sum_{t=1}^{|y|} \min \left( r_t(\theta)\hat A_t,, \operatorname{clip} (r_t(\theta),1-\epsilon,1+\epsilon)\hat A_t \right) \right] \end{equation}\) 其中: \(\begin{equation} r_t(\theta) = \frac{ \pi_\theta(y_t|q,y_{<t}) }{ \pi_{\theta_{\text{old} }}(y_t|q,y_{<t}) } \end{equation}\) 是当前策略与旧策略在第 $t$ 个 token 上的概率比值,即重要性采样;而 $\epsilon$ 是 clipping 的超参数;$\hat A_t$ 是这个 token 对应的 advantage:
- $\hat A_t>0$:这个 action 比预期好,希望提高概率;
- $\hat A_t<0$:这个 action 比预期差,希望降低概率。
因此,clipping 就是在限制:即便这个 token 很好/很差,也不要一次把概率改得太猛。
PPO
标准 PPO 通常采用 Actor-Critic 架构,除了作为 policy 的 Actor $\pi_\theta$,还需要额外训练一个 Critic $V_\phi$,其中:
- $\phi$:Value Model 的参数;
- $V_\phi(s_t)$:估计当前状态 $s_t$ 未来能够获得多少 return。
对于 LLM,$s_t=(q,y_{<t})$,也就是 prompt + 当前 token 之前已经生成的内容。Critic 的训练目标是最小化:
\[\begin{equation} \mathcal L_\phi^{VF} = \mathbb E \left[ \left( V_\phi(q,y_{<t})-R \right)^2 \right] \end{equation}\]其中 $R$ 是累计 reward。本质就是让 Critic 学会预测:走到这里的时候,最终大概能获得多少 reward?
GAE
为了在 advantage 估计的 bias(偏差)和 variance(方差)之间做权衡,PPO 使用 Generalized Advantage Estimation,它本质上是在回答:当前这个 action,到底比 Critic 原本预期的平均水平好多少。 \(\begin{equation} \hat A_t^{GAE} = \sum_{l=0}^{|y|-t-1} (\gamma\lambda)^l \delta_{t+l} \end{equation}\) 其中 TD error: \(\begin{equation} \delta_t = r_t+\gamma V_\phi(s_{t+1})-V_\phi(s_t) \end{equation}\) 这里:
- $s_t$:第 $t$ 个状态
- $V_\phi(s_t)$:Critic 对当前状态价值的预测
- $r_t$:当前 step 得到的 reward
- $\gamma$:discount factor
- $\lambda$:GAE 的衰减参数
- $\delta_t$:一步 TD error
- $\hat A_t^{GAE}$:最终的 advantage estimate
PPO 虽然有效,但需要额外维护一个 Value Model,相当于又保存了一套模型参数,因此训练时的显存占用基本会显著增加,同时也带来额外计算开销。
具体来看,Critic 给当前状态一个价值估计 $V(s_t)$(即状态价值),其中,$s_t$ 是第 $t$ 步的状态;$V(s_t)$ 是从 $s_t$ 开始,未来大概能获得多少累计 reward。真正走一步之后,会看到 $r_t + \gamma V(s_{t+1})$(即动作价值),其中,$r_t$ 是这一步实际获得的 reward;$\gamma$ 是 discount factor;$V(s_{t+1})$ 是下一状态未来价值的预测。于是可以比较 $r_t+\gamma V(s_{t+1})$ 和之前 Critic 的预测 $V(s_t)$,两者之差就是 TD error:$\delta_t = r_t+\gamma V(s_{t+1})-V(s_t)$。
例如,Critic 原本认为,$V(s_t)=0.5$,走一步以后 $r_t=0.1$,下一状态 $V(s_{t+1})=0.8$。假设 $\gamma=1$,那么 $\delta_t = 0.1+0.8-0.5 = 0.4$,意思就是实际走完这一步之后发现,情况比原本预期好 $0.4$。因此,$\delta_t>0$ 说明这个 action 倾向于是好的。如果 $\delta_t<0$,则说明这一步之后的情况比 Critic 原本预期更差。
因此这个 $\delta_t$ 就可以理解为该动作的优势,不过它只看了下一步。但问题在于,有时候一个 action 的好坏,要过很多步以后才能体现,只看 $\delta_t$ 可能太短视。那么可以把后面的 TD error 也加进来。例如,$\delta_t$ 看一步,再考虑下一步: \(\begin{equation} \begin{aligned} \delta_t+\gamma\delta_{t+1} &= [r_t+\gamma V(s_{t+1})-V(s_t)] + [\gamma r_{t+1} + \gamma^2 V(s_{t+2}) - \gamma V(s_{t+1})] \\ &= [r_t + \gamma r_{t+1} + \gamma^2 V(s_{t+2})] - V(s_t) \end{aligned} \end{equation}\) 再往后: \(\begin{equation} \delta_t + \gamma\delta_{t+1} + \gamma^2\delta_{t+2} +\cdots \approx R_t-V(s_t) \end{equation}\) 这样就能把更远的未来反馈传播回来。但如果把整个 trajectory 全加进来,又会产生一个问题:方差很大,因为越远的未来,随机因素越多。
所以 GAE 引入一个额外的衰减参数 $\lambda$,得到: \(\begin{equation} \hat A_t^{GAE} = \delta_t + \gamma\lambda\delta_{t+1} + (\gamma\lambda)^2\delta_{t+2} +\cdots \end{equation}\) 即: \(\begin{equation} \hat A_t^{GAE} = \sum_{l=0}^{T-t-1} (\gamma\lambda)^l\delta_{t+l} \end{equation}\) $\lambda$ 的作用是什么?这是 GAE 最核心的地方。当 $\lambda=0$,那么 $A_t=\delta_t$,只看一步。优点是方差低、更稳定;缺点是很依赖 Critic 是否准确,bias 较大。当 $\lambda=1$ 则 $A_t = \delta_t + \gamma\delta_{t+1} + \gamma^2\delta_{t+2} +\cdots$ 它会接近 $A_t \approx R_t-V(s_t)$,也就是实际最终回报减去 Critic 原本预测。优点是 bias 小,使用了真实的长期 reward;缺点是方差大。因此,$\lambda$ 是在 bias 和 variance 之间做 trade-off。实际 PPO 中经常使用 $\lambda=0.95$。
一个具体例子,假设有三个 timestep $t=1,2,3$,TD error 分别为:$\delta_1=0.2$,$\delta_2=0.4$,$\delta_3=-0.1$。假设 $\gamma=1$,$\lambda=0.9$。那么第 1 步的 GAE: \(\begin{equation} A_1 = 0.2 + 0.9\times0.4 + 0.9^2\times(-0.1) = 0.2+0.36-0.081 = 0.479 \end{equation}\) 可以看到,当前 $\delta_1$ 有影响,下一步 $\delta_2$ 也有影响,更远的 $\delta_3$ 仍然有影响,但是影响逐渐衰减。所以 GAE 可以理解为对未来 TD error 做指数加权求和。那么为什么不用直接 $R_t-V(s_t)$?最直接的 advantage 的确可以写成 $A_t=R_t-V(s_t)$,问题是 $R_t$ 依赖整条未来 trajectory,因此随机性非常大。GAE 则通过 Value Model $V(s_{t+1}),V(s_{t+2}),…$ 提前截断一部分未来的不确定性。所以它实际上介于纯 TD 和纯 Monte Carlo Return 之间。
二、使用 Single Rollout 的异步 RL
SAO 要解决异步 RL 中的两个主要问题:训练不稳定(training instability)和 off-policy drift。通过一种简单的 token-level clipping 策略,并使用 single rollout 作为 group-wise sampling 的替代方案,最终让异步 RL 能够稳定地训练到上千步并获得显著性能提升。
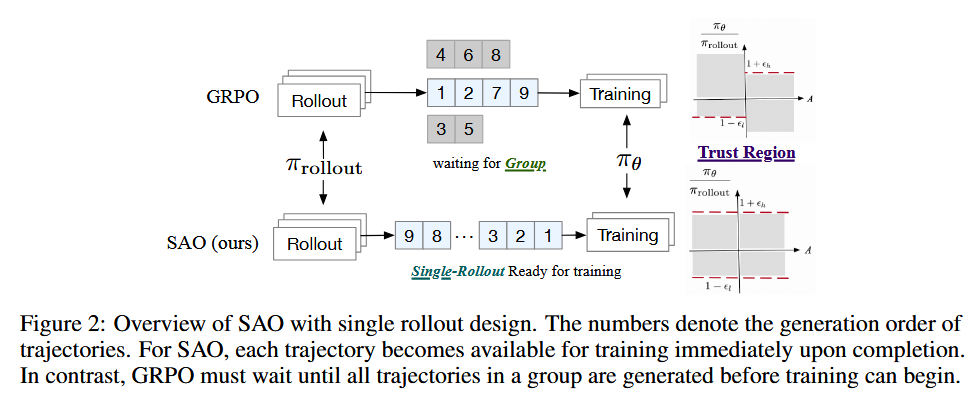
SAO 可以概括为: \(\begin{equation} \boxed{ \text{SAO} = \text{异步训练} + \text{DIS} + \text{Single Rollout} + \text{Critic/GAE 改进} } \end{equation}\)
(一)通过直接双侧重要性采样稳定异步 RL
直接双侧重要性采样即 Direct Double-Sided Importance Sampling (DIS)。
这里首先要弄明白几个问题:
- 异步 RL 中,一条 trajectory 会不会由多个策略生成?
在 SAO 所讨论的异步 LLM/Agent RL 中,会。 论文明确说,一条 trajectory 可能由多个版本的 old rollout model 生成,而且 rollout engine 可能在单条 trajectory 生成期间经历多次权重更新。当然,这不是所有异步 RL 必然如此,而取决于系统怎么更新 rollout worker 的权重。
例如一个 Agent trajectory $T=[a_0,o_0,a_1,o_1,a_2,\dots]$,其中:
- $a_i$:模型第 $i$ 轮生成的 action
- $o_i$:环境/工具返回的 observation
假设开始时 rollout engine 是 $\pi^{(0)}$,于是第一轮有 $a_0\sim\pi^{(0)}$。随后模型调用工具,等工具执行的过程中,trainer 已经更新了参数,并把新权重同步给 rollout engine $\pi^{(0)}\rightarrow\pi^{(1)}$,于是下一轮 $a_1\sim\pi^{(1)}$。再过一会儿 $a_2\sim\pi^{(2)}$,最终这整条 trajectory 是 $a_0\sim\pi^{(0)},\quad a_1\sim\pi^{(1)},\quad a_2\sim\pi^{(2)}$。所以严格说,不存在一个单独的 checkpoint 能代表整条 trajectory 的 behavior policy。
- 什么是 Decoupled PPO?
这里需要把算法里的 PPO 和系统实现里的异步/解耦 PPO 分开。算法中的标准同步 PPO 有: \(\begin{equation} r_t= \frac{\pi_\theta(a_t|s_t)} {\pi_{\text{old} }(a_t|s_t)} \end{equation}\) 因为标准 PPO 的流程基本是: \(\begin{equation} \pi_{\text{old} } \xrightarrow{\text{rollout} } D \xrightarrow{\text{training} } \pi_\theta \end{equation}\) 也就是说,生成数据的模型本来就是 $\pi_{\text{old} }$,因此实际上 $\pi_{\text{rollout} } = \pi_{\text{old} }$,那么自然 $\frac{\pi_{\text{old} }}{\pi_{\text{rollout} }}=1$。
Decoupled 的意思主要是系统层面的 rollout 和 training 解耦: \(\begin{equation} \boxed{\text{Rollout workers} } \qquad\parallel\qquad \boxed{\text{Trainer} } \end{equation}\) 两边可以同时工作。例如 trainer 当前已经到了 $\pi_{\theta}$,PPO 这一轮保存的 reference old policy 是 $\pi_{\theta_{\text{old} }}$,但是 rollout worker 因为权重同步有延迟,它生成这批数据时可能还在 $\pi_{\text{rollout} }$,于是 $\pi_{\text{rollout} } \neq \pi_{\theta_{\text{old} }} \neq \pi_\theta$,因此 decoupled PPO 中需要同时考虑三个 policy。
因此,异步 decoupled PPO 里通常有三层概念 $\pi_{\text{rollout} } \quad \leftrightarrow \quad \pi_{\text{old} } \quad \rightarrow \quad \pi_\theta$,其中:
- $\pi_{\text{rollout} }$:这个 token 真正被生成时,rollout engine 上的实际分布
- $\pi_{\text{old} }$:与这个 rollout 版本对应的、trainer 侧冻结下来的 old policy snapshot,可以理解为 trainer 侧保存的一个历史训练策略基准
- $\pi_\theta$:trainer 当前已经更新到的最新 policy
$\pi_{\text{old} }/\pi_{\text{rollout} }$ 修正同一版本下训练端与推理端的分布差异,例如 trainer 侧可能是 PyTorch/FSDP training forward,而推理侧可能是 vLLM / SGLang 推理引擎,会存在精度、kernel、权重同步时机等差异;而 $\pi_\theta/\pi_{\text{old} }$ 则修正 historical policy 到 current policy 的 policy staleness。
假设 trainer 的模型版本不断变化 $\pi^{(10)} \rightarrow \pi^{(11)} \rightarrow \pi^{(12)} \rightarrow \pi^{(13)}$,一条很长的 Agent trajectory 在 version 10 时开始,某一段 token 是 $a_{1:100}\sim\pi_{\text{rollout} }^{(10)}$。那么理论上,与这段数据对应的 old policy 应该是 $\pi_{\text{old} }=\pi^{(10)}$。那传统做法怎么保存这个 $\pi_{\text{old} }$?最直接的方法就是版本化 checkpoint / snapshot。比如 rollout 数据同时记 $(\text{tokens},\ \text{policy version}=10)$,trainer 收到以后知道这批数据对应 version 10,于是保留 $\pi^{(10)},\pi^{(11)},\pi^{(12)},\dots$。这些历史 snapshot,在需要的时候重新 forward 计算 $\log\pi_{\text{old} }(a_t|s_t)$。现在的一些异步 RL 工作把这种方法称作 snapshot-based version tracking,除此之外,还有专门维护 old-logit model,或者通过中断/同步 rollout 来确保 old logits 可恢复的方法。问题就是,异步程度越高,需要保留的历史版本越多,这很贵。
异步强化学习中的一个主要挑战,是 rollout model(采样模型)与 training model(训练模型)之间出现的 policy lag(策略滞后)。比如 $\pi_{\text{rollout} }$ 生成了一条 trajectory,但 trajectory 生成期间 trainer 一直在更新: \(\begin{equation} \pi_0 \rightarrow \pi_1 \rightarrow \pi_2 \rightarrow \pi_3 \end{equation}\) 等 trajectory 回来的时候,训练模型已经是 $\pi_\theta=\pi_3$,于是 $\pi_{\text{rollout} }\neq\pi_\theta$ 这就是 off-policy。
在解耦式 PPO(decoupled PPO)中,训练和生成是分开的,所以其实存在两个 gap。通常使用重要性采样(importance sampling)来缓解 off-policy bias。为此,需要维护三个不同的模型,分别是:
| 符号 | 含义 |
|---|---|
| $\pi_\theta$ | 当前正在训练的最新 policy |
| $\pi_{\theta_{\text{old} }}$ | PPO 中固定下来的 old policy |
| $\pi_{\text{rollout} }$ | 真正负责生成 trajectory 的 rollout policy |
其中 $\frac{\pi_\theta}{\pi_{\theta_{\text{old} }} }$ 用于对滞后的 off-policy 进行修正,而 $\frac{\pi_{\theta_{\text{old} }} } {\pi_{\text{rollout} }}$ 用于修正训练模型与 rollout 模型之间的不匹配。然而,在异步 RL 的一条 trajectory 的生成过程中,rollout engine 可能会经历多次模型更新,因此,精确追踪行为概率 $\pi_{\theta_{\text{old} }}$ 在计算上代价过高。否则,我们就不得不维护大量历史模型 checkpoint:$\lbrace \pi_{\theta_{\text{old} }^{(1)} }, \dots, \pi_{\theta_{\text{old} }^{(N)} } \rbrace$,这在实际实现中是不可行的。为了解决这一问题,文章提出了一种简化但更加激进的 token 级重要性采样方法,用于裁剪 off-policy token。
第一个改动:Direct Importance Sampling。直接使用 $\pi_{\text{rollout} }$ 作为 behavior proxy(行为策略的代理),并使用 $\pi_\theta$ 进行重要性采样,即 $r_t(\theta)=\frac{\pi_\theta}{\pi_{\text{rollout} }}$,同时舍弃不准确的 $\pi_{\theta_{\text{old} }}$。这可以直接利用 rollout 阶段生成的 log-probability,避免单独进行 old-policy inference 从而带来计算开销。
第二个改动:Double-Sided。采用一种双侧校准式 token-level masking(double-sided calibration token-level masking)策略。标准 PPO 使用: \(\begin{equation} \min \left( r_tA_t, \operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A_t \right) \end{equation}\) 例如设 $1-\epsilon=0.8,\quad 1+\epsilon=1.2$。
当 $A_t>0$ 时,这个 token 是好 token,我们希望提高它的概率。如果 $r_t>1.2$ 说明概率已经提高太多,此时进行 clip。但是如果 $r_t<0.8$ 标准 PPO 不会把它 mask 掉。因为这是一个好 action $A_t>0$,结果当前 policy 反而把它概率降低很多,那当然应该继续给梯度,把它概率拉回来。
当 $A_t<0$ 时,这个 token 是坏 token,我们希望降低它的概率。如果 $r_t<0.8$ 说明已经把坏 token 的概率降很多了,要进行 clip。但如果 $r_t>1.2$ 也不会 clip 掉,因为坏 token 的概率居然还大幅提高了,更应该给梯度把它拉回来。
所以标准 PPO clipping 是方向相关的:当 $(A > 0, \quad r_t(\theta) > 1+\epsilon_h)$ 或者 $(A<0,\quad r_t(\theta)<1-\epsilon_l)$ 时进行裁剪。而 SAO 则将 trust region(信赖区域)限制在 $[1-\epsilon_l,\ 1+\epsilon_h]$ 之内。对于落在该范围之外的 token,完全将其从梯度计算中 mask 掉,从而防止由极端 policy divergence(策略分歧)导致的训练不稳定。
比如 $[1-\epsilon_l,1+\epsilon_h]=[0.8,1.2]$,那么 $r_t=1.1$ 保留,但 $r_t=1.5, \ r_t=0.5$ 直接 $f(r_t)=0$,无论 $A_t$ 是正还是负。所以这里与普通 PPO 有一个本质区别:PPO ratio 超界不一定不要这个 token,还要结合 $A_t$ 的正负判断。SAO DIS 只要 $r_t \notin [1-\epsilon_l,1+\epsilon_h]$ 就认为当前 policy 和生成这个 token 的 rollout policy 差得太远,这个 token 已经过于 off-policy,直接 mask,不参与梯度。它的思路是:与其相信一个严重过时的 token 所产生的巨大 importance weight,不如直接扔掉。
形式化地,采用 token-level clipping 后的优化目标可以写为: \(\begin{equation} \boxed{ L(\theta) = \hat{\mathbb E}_t \left[ f(r_t(\theta),\epsilon_l,\epsilon_h) \hat A_t \log\pi_\theta(a_t|s_t) \right] } \end{equation}\) 在这一公式中,概率比率 $r_t(\theta)$ 直接通过 rollout 阶段记录的日志计算,从而避免追踪历史策略: \(\begin{equation} \boxed{ r_t(\theta) = \exp \left( \log\pi_\theta(a_t|s_t) - \log\pi_{\text{rollout} }(a_t|s_t) \right) } \end{equation}\) 稳定性进一步通过校准函数 $f(x;\epsilon_l,\epsilon_h)$ 来保证: \(\begin{equation} \boxed{ f(x;\epsilon_l,\epsilon_h) = \begin{cases} x, & 1-\epsilon_l<x<1+\epsilon_h \\ 0, & \text{otherwise} \end{cases} } \end{equation}\) 这种设计避免了追踪历史模型集合所带来的巨大开销。这是以接受一定可控的 off-policy bias 为代价,换取不追踪历史 policy ensemble 的计算简化和更稳定的异步训练。实验结果表明,这一简化机制允许采用更加激进的 clipping,从而有效地对更新 step 进行正则化,并在异步训练场景下获得更好的训练稳定性。
(二)通过单轨迹降低 Off-Policy
在异步强化学习中,一个不可避免的问题是 off-policy。然而,当前流行的基于组采样的强化学习算法,例如 GRPO,可能会引入更加严重的 off-policy 问题。组采样会引入一种“不平衡生成(imbalanced generation)”偏差:一组数据必须等待其中最慢的样本生成完成之后,才能被送入训练。一种很有前景的解决方案,是使用 single-rollout(单轨迹)替代 group-wise sampling:一个样本一旦生成完成,就立即送入训练。
然而,与 REINFORCE 类似,single-rollout optimization 天然存在梯度估计方差较高的问题。为了降低这种方差,需要一个足够好的 Value Model(价值模型)。
1. 更快的 Value Update
论文发现,在 single-rollout RL 中,不稳定性的主要来源,是 policy 与 value function 之间的相互依赖。如果 Value Model $V_\phi$ 不够准确,那么 advantage estimate $\hat A_t$ 就会变得噪声很大,从而导致破坏性的 policy 更新。为了缓解这一问题,论文使用了一种 Faster Value Update 策略。具体而言,将 policy 和 Value Model 的优化频率进行解耦。每当 policy $\pi_\theta$ 执行 1 次梯度更新时,要求 Value Network $V_\phi$ 执行 $K$ 次更新,其中$K>1$。在实验中,论文设置 $K=2$,这种策略使 Value estimate 能够在用于 advantage 计算之前,更快地适应当前 policy,从而降低方差。
2. 通过参数冻结稳定 Value Model 训练
在实验中,论文发现 Value Model 的训练存在不稳定现象,其中 Value Model 的梯度范数明显大于对应的 Policy Model。进一步分解后发现,这种不稳定性主要来源于 Full Attention 层,而 MoE 层则相对稳定。基于这一观察,论文对 Value Model 使用了一种 冻结 Attention 的训练策略。在 RL 训练期间,冻结 $V_\phi$ 中的 Attention 模块参数,只优化 MoE projections。这一假设是:经过预训练的 Attention 权重已经具备足够的语义能力,能够关注相关 token。因此,通过将优化限制在 MoE 层,能够有效地对 Value Model 进行正则化。
3. 面向 Agentic Tasks 的 Skip-Observation Token-level GAE
Agentic task 的 trajectory 结构给 token-level value estimation 带来了一个特殊挑战。一条 trajectory 可以表示为 $T= [a_0,o_0,a_1,o_1,\dots]$,其中,$a_i$ 是模型生成的 action;$o_i$ 是环境返回的 feedback。标准的 Generalized Advantage Estimation(GAE)会尝试计算相邻 token 之间的 value difference。然而,从一个 action 的最后一个 token $a_{i,\text{end} }$ 到 observation 的第一个 token $o_{i,\text{start} }$ 这一转移,从模型的视角来看是不连续的,因为 $o_i$ 并不是由模型生成的。跨越这一边界计算 advantage 会引入噪声,因为此时 Value Model $V(o_{i,\text{start} })$ 实际上是在尝试预测一个外部环境状态的 value。
为了解决这一问题,论文推导了一种 Skip-Observation GAE,显式的修改了 Bellman target,使其跳过环境反馈 token,直接将当前 action 的 value 与下一个 action 的 value 连接起来。形式化地,令 $a_{i,N}$ 表示第 $i$ 个 action 的最后一个 token,而 $a_{i+1,0}$ 表示下一个 action 的第一个 token。将 advantage 定义为: \(\begin{equation} \boxed{ \hat A(a_{i,N}) = \delta + \gamma\lambda \hat A(a_{i+1,0}) } \end{equation}\) 其中,TD residual $\delta$ 跨过 observation gap 计算: \(\begin{equation} \boxed{ \delta = r_t + \gamma V(a_{i+1,0}) - V(a_{i,N}) } \end{equation}\) 这种形式将 advantage estimation 限制为仅依赖模型自身的输出,从而过滤掉由环境反馈随机性所带来的影响。相比之下,一些工作可能会考虑采用 step-level Value Function 和 GAE 来替代 token-level value。然而,论文发现 step-level value 可能会导致次优的性能。
4. 扩大 Value Model 预训练规模
最后,为了支持上述机制,扩大用于 Value Model 预训练的数据规模是非常重要的。实验表明,Value estimation 中的 cold start(冷启动)问题是一个主要瓶颈。通过显著扩大 Value Model 预训练语料的规模,可以为 Value Model 提供了一个更加稳健的初始化点,从而使 single-rollout 和 Two-Time-Scale Update Rule (TTUR) 机制能够从训练早期就更加有效地发挥作用。
三、实验
(一)实验设置
对于使用 Python 的数学推理任务,首先使用由 GPT-OSS-120B 生成的 Tool-Integrated Reasoning(TIR)数据,对 Qwen3-30B-A3B-Thinking-2507 进行 3 个 epoch 的微调,并使用微调后的模型来初始化 Policy Model 和 Value Model。TIR 要求模型将自然语言形式的数学推理与 Python 工具调用交错进行。
RL 训练的主要设置为:
- batch size = 128
- group size = 1
- 最大长度 = 128K tokens
Policy 的学习率设为 $1\times10^{-6}$,token clipping 参数设为 $\epsilon_{\text{low} }=0.3,\epsilon_{\text{high} }=5.0$。采用 length-adaptive GAE,$\lambda_{\text{policy} } = 1-\frac{1}{\alpha l}$,其中 $\alpha=1.5$。Value Model 的学习率设置为 $5\times10^{-6}$,并设置 $\lambda_{\text{critic} }=1$,同时使用 10-step warmup。对于 Value Model 的 Faster Value Update,设置 $K=2$,即每个 batch 对 Value Model 执行两次更新。GRPO baseline 则使用 16 个 prompt,每个 prompt 采样 8 条 rollout,因此总 batch size 同样是 128。
对于 coding agent 的 RL 训练,直接使用 Qwen3-30B-A3B-Thinking-2507 进行训练,并保持几乎所有超参数与 TIR 设置一致,区别仅在于 $\epsilon_{\text{low} }=0.8$ 以及 $\epsilon_{\text{high} }=3.0$。对于 SWE-Bench Verified,使用 OpenHands 作为 agent scaffold,最多允许:
- 300 个交互 turn
- 128k token 的 context budget
(二)主要结果
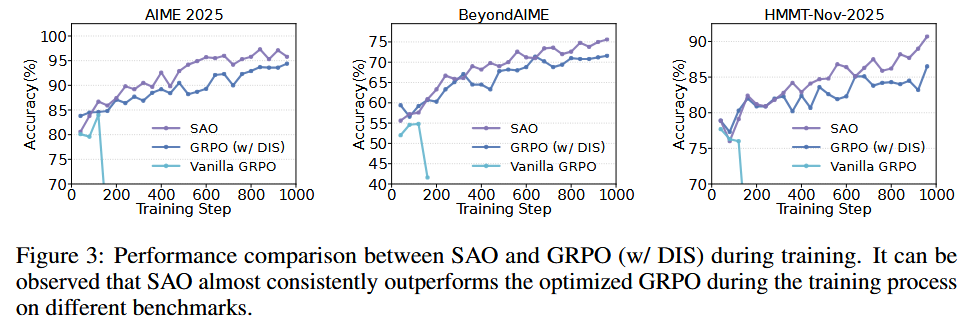
在数学推理和 Coding Agent benchmark 上,SAO 都优于 GRPO baseline。
主要现象是:
- Vanilla GRPO 在大约 160 steps 后出现性能崩溃;
- 给 GRPO 加入本文提出的 DIS 后,可以明显稳定训练;
- SAO 在训练前期和 GRPO + DIS 表现接近;
- 大约 400 steps 以后,SAO 开始明显优于 GRPO + DIS。
(三)消融实验
- Faster Value Update
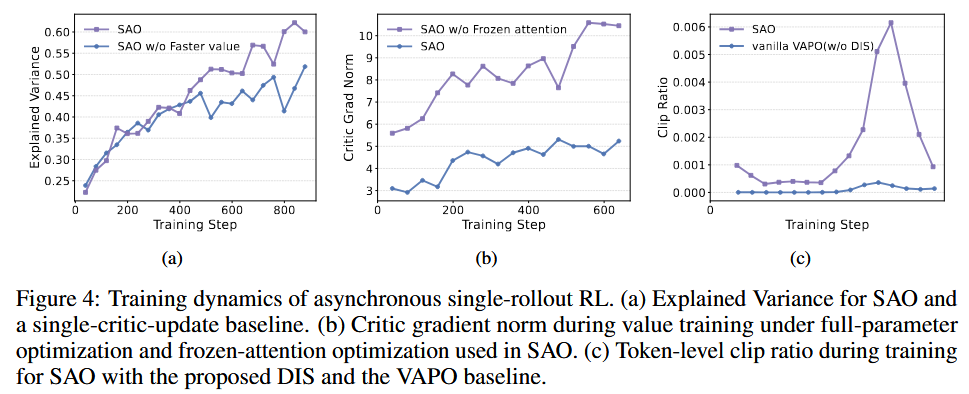
如果 Critic 每个 batch 只更新一次,而不是 2 次,性能下降。说明 Critic 更新得太慢时,无法跟上不断变化的 Policy distribution,从而导致 advantage estimation 变差。
- Frozen Attention
如果 Value Model 不冻结 Attention,而是进行全参数训练,效果也下降,而且 Critic 的 gradient norm 明显更大。冻结 Attention、只训练 MoE/FFN 部分,可以让 Value Model 的训练更加稳定。
- Vanilla VAPO 与使用 Running-Mean Baseline 的 Single-Rollout
此外还比较了:
-
Vanilla VAPO:标准 VAPO,使用 length-adaptive GAE 和基于 Value 的 RL baseline。
-
single-rollout baseline:对于每个 prompt,维护其最近 8 个 reward 的滑动窗口,并使用它们的平均值作为 advantage estimation 的 baseline。
使用 running-mean reward 的 RL 也能够获得尚可的性能,但仍然明显落后于 SAO。这说明,对于 RL 来说,一个训练良好的 Value Model 具有明显优势,而且是必要的。至于 vanilla VAPO,它同 vanilla GRPO 一样,也会在训练过程中迅速发生崩溃。
(四)训练动力学
第一,Critic 每 batch 更新 2 次时,Explained Variance 更高。Explained Variance 用于衡量预测 Value $V(s)$ 与 ground-truth return $R$ 之间的一致程度,其定义为: \(\begin{equation} EV = 1- \frac{ \operatorname{Var}(R-V(s)) }{ \operatorname{Var}(R) } \end{equation}\) 大约经过 400 training steps 之后,SAO 表现出明显更高的 Explained Variance。这表明 Value Model 收敛得更快,与 Policy distribution 的匹配程度更高。
第二,冻结 Attention 后,Value Model 的 gradient norm 更低、更平滑,说明训练更加稳定。
第三,DIS 会主动 mask 掉严重 off-policy 的 token,而不使用 DIS 的 VAPO 虽然表面上的 clip ratio 很低,却很快发生训练崩溃。这说明普通 PPO clipping 对异步场景中的严重 policy lag 不够强,而 DIS 的双侧 token masking 更有效。
(五)在线学习模拟
在真实世界的在线学习环境中,对于每个 prompt,反馈通常被限制为单条 trajectory。这种限制与 GRPO 这类 group-based optimization 策略天然不兼容,因为 GRPO 需要依赖一个 sample group 内的相对 reward 进行 advantage estimation。
相比之下,SAO 使用一个基于 Value 的 Critic 来进行 advantage estimation,因此能够利用单独的一条 trajectory 有效地进行 Policy 更新。文章设计了一个模拟在线写作任务,用于评估 SAO 在 non-stationary environment(非平稳环境)中的适应能力。在这一设置中,反馈信号被设计为用户对于语言风格的偏好。Reward criterion 会依次发生变化,分别偏好三种不同的语言风格原型:
- Cute:可爱风格
- Chuunibyou:中二风格
- Classical:古典风格
每个 prompt 只产生 1 条 trajectory,这模拟真实在线学习环境,因为真实用户一般不会针对同一个 prompt 同时给你 8 个 rollout 的反馈。结果显示 SAO 可以在 reward preference 改变后快速适应新的风格。相比之下,使用历史 reward 滑动平均的 baseline 会产生明显的 adaptation lag,因为窗口中还残留旧 reward distribution。
四、总结
本文研究了如何提高异步 RL 的训练效果和训练稳定性。文章提出 SAO(Single-Rollout Asynchronous Optimization),用于解决异步训练中的 off-policy 和训练不稳定问题。SAO 主要通过两方面实现这一目标:使用 Token-level Importance Sampling + Double-Sided Clipping/Masking 来稳定异步训练。同时使用 Single Rollout + 更强的 Value Model 训练替代 group-wise sampling,从而改善泛化能力。在 Agentic reasoning 和 Coding 任务上,SAO 持续优于 GRPO baseline;在模拟在线学习实验中,它也能够有效适应不断变化的环境。