【论文解读】 Muon
Categories: Paper
目录
概览
近期,基于矩阵正交化的 Muon 优化器在小规模语言模型训练中取得了良好的效果,但其能否扩展到更大规模的模型尚未得到验证。
本文发现使 Muon 能够扩展至大规模训练的两项关键技术:(1)引入权重衰减;(2)谨慎调整逐参数更新尺度。这些技术使 Muon 能够直接应用于大规模训练,无需进行超参数调优。缩放定律实验表明,在计算量最优的训练设置下,Muon 的计算效率约为 AdamW 的两倍。
Muon 原博客链接:Muon: An optimizer for hidden layers in neural networks
论文链接:Muon is Scalable for LLM Training
配合阅读:【笔记】从 SGD 到 Muon
一、引言
训练具备强大能力的大语言模型是一个计算密集、资源需求极高的过程。优化器在大语言模型的高效训练和有效训练中发挥着至关重要的作用。目前,Adam 及其变体 AdamW 是大多数大规模模型训练中的标准选择。
近期,优化算法领域的发展展现出了超越 AdamW、进一步提升训练效率的潜力。在这些方法中,K. Jordan 等人于 2024 年提出了 Muon。该优化器使用牛顿—舒尔茨迭代(Newton-Schulz iteration),通过对梯度动量进行正交化来更新矩阵参数。Muon 最初在小规模语言模型训练中的实验取得了令人鼓舞的结果。然而,正如 K. Jordan 等人在其技术博客中讨论的那样,仍有几个关键问题尚未得到解决:
- 如何有效扩展基于矩阵正交化的优化器? 如何将这类优化器扩展到具有数十亿参数、使用数万亿词元进行训练的大规模模型?
- 如何在分布式环境中进行计算? 如何在分布式训练环境下计算近似正交化结果?
- 能否适用于不同的训练阶段? 这类优化器能否在不同训练阶段中保持良好的适用性,包括预训练和监督微调?
本文针对上述挑战展开了全面研究。
二、方法
(一)背景
1. Muon 优化器
Muon 用于优化可表示为矩阵的神经网络权重。在第 $t$ 次迭代中,给定当前权重 $W_{t-1}$、动量系数 $\mu$、学习率 $\eta_t$ 和目标函数 $L_t$,Muon 优化器的更新规则如下: \(\begin{equation} \begin{aligned} M_t &= \mu M_{t-1}+\nabla L_t(W_{t-1}) \\ O_t &= \operatorname{Newton\text{-}Schulz}(M_t) \\ W_t &= W_{t-1}-\eta_t O_t \end{aligned} \label{eq:muon} \end{equation}\) 其中,$M_t$ 是第 $t$ 次迭代时的梯度动量,在 $t=0$ 时初始化为零矩阵。在上式中,采用牛顿—舒尔茨迭代(Newton-Schulz iteration)来近似求解正交化后的矩阵 $(M_tM_t^\top)^{-1/2}M_t$。设 $M_t$ 的奇异值分解(Singular Value Decomposition,SVD)为: \(\begin{equation} M_t=U\Sigma V^\top \end{equation}\) 其中,$U$ 是左奇异向量构成的正交矩阵,$V$ 是右奇异向量构成的正交矩阵,$\Sigma$ 是包含奇异值 $\sigma_i$ 的对角矩阵。则有: \(\begin{equation} \begin{aligned} M_tM_t^\top &=U\Sigma V^\top V\Sigma^\top U^\top\\ &=U\Sigma\Sigma^\top U^\top \end{aligned} \end{equation}\) 因此: \(\begin{equation} (M_tM_t^\top)^{-1/2} = U(\Sigma\Sigma^\top)^{-1/2}U^\top \end{equation}\) 将它与 $M_t$ 相乘: \(\begin{equation} \begin{aligned} (M_tM_t^\top)^{-1/2}M_t &=U(\Sigma\Sigma^\top)^{-1/2}U^\top U\Sigma V^\top\\ &=U(\Sigma\Sigma^\top)^{-1/2}\Sigma V^\top \end{aligned} \end{equation}\) 由于 $\Sigma\Sigma^\top$ 的非零对角元素是 $\sigma_i^2$,因此其逆平方根对应的元素是 $\frac{1}{\sqrt{\sigma_i^2} } =\frac{1}{\sigma_i}$,与原来的奇异值 $\sigma_i$ 相乘 $\frac{1}{\sigma_i}\sigma_i=1$。因此,所有非零奇异值都被归一化为 1,最终得到: \(\begin{equation} (M_tM_t^\top)^{-1/2}M_t=UV^\top \end{equation}\) 因此,这一操作对 $M_t$ 进行了正交化。直观而言,正交化能够确保更新矩阵具有同构性(isomorphic),从而防止权重仅沿少数占主导地位的方向进行学习。在实际应用中,遵循 K. Jordan 等人的做法,采用 Nesterov 风格的动量,即将 $\mu M_t+\nabla L_t(W_{t-1})$ 输入牛顿—舒尔茨迭代过程,而不是直接输入 $M_t$,这可以理解为在已有动量方向上做一个前瞻式的更新估计。
2. 用于矩阵正交化的牛顿—舒尔茨迭代
公式 $\eqref{eq:muon}$ 通过迭代过程计算。首先,设置: \(\begin{equation} X_0=\frac{M_t}{\|M_t\|_F} \end{equation}\) 其中,$|\cdot|_F$ 是 Frobenius 范数定义为: \(\begin{equation} \|M_t\|_F= \sqrt{\sum_i\sum_j(M_t)_{ij}^2} \end{equation}\) 归一化后有 $|X_0|_F=1$。随后,在每次迭代 $k$ 中,根据 $X_{k-1}$ 更新 $X_k$: \(\begin{equation} X_k=aX_{k-1} +b(X_{k-1}X_{k-1}^\top)X_{k-1} +c(X_{k-1}X_{k-1}^\top)^2X_{k-1} \end{equation}\) 经过 $N$ 次迭代后,该过程的结果为 $X_N$。其中 $a$、$b$ 和 $c$ 为系数。设当前矩阵为 $X_{k-1}=U_r\Sigma_{k-1} V_r^\top$,其中 $r$ 是矩阵的秩,代入上式可以得到: \(\begin{equation} \begin{aligned} X_k &=aU_r \Sigma_{k-1} V_r^\top +bU_r \Sigma_{k-1}^3V_r^\top +cU_r \Sigma_{k-1}^5V_r^\top\\ &=U_r\left(a\Sigma_{k-1}+b\Sigma_{k-1}^3+c\Sigma_{k-1}^5\right)V_r^\top \end{aligned} \end{equation}\)
因此,在精确算术下,这个过程保留左右奇异向量,只对每个非零奇异值应用同一个多项式:
\[\begin{equation} \sigma_{k}=a\sigma_{k-1}+b\sigma_{k-1}^3+c\sigma_{k-1}^5 \end{equation}\]通过选择合适的系数,就可以把不同大小的非零奇异值逐步调整到接近 1 的尺度,从而近似得到正交化后的更新矩阵。在 K. Jordan 等人的原始设计中,系数设置为 $a=3.4445,b=-4.7750,c=2.0315$。这一设置旨在使迭代过程在初始奇异值较小时能够更快收敛。本工作中采用相同的系数设置。
3. 范数约束下的最速下降
Bernstein 等人提出,可以将深度学习中的优化过程视为范数约束下的最速下降。
优化器可以理解为:给定当前梯度,规定每一步更新的大小如何衡量,然后寻找在这一约束下能够最快降低损失的更新方向。Adam 和 Muon 的一个重要区别,就是它们采用了不同的更新几何。这里从三个方面来理解:梯度、范数约束、最速下降。
梯度
假设模型参数为 $W$,损失函数为 $L(W)$,当前梯度为 $G=\nabla L(W)$。当参数发生一个较小的变化 $\Delta W$ 时,可以用一阶泰勒展开近似损失变化: \(\begin{equation} L(W+\Delta W) \approx L(W)+\langle G,\Delta W\rangle_F \end{equation}\) 这里的 $\langle G,\Delta W\rangle_F$ 表示两个矩阵的 Frobenius 内积,对于两个同维度矩阵 $A,B$,定义: \(\begin{equation} \langle A,B\rangle_F =\operatorname{tr}(A^\top B) =\sum_i\sum_j A_{ij}B_{ij} \end{equation}\) 其中,$\operatorname{tr}$ 表示矩阵的迹,即主对角线元素之和。直观上,将两个矩阵对应位置的元素相乘,再把所有乘积相加,就得到 Frobenius 内积。
为了降低损失,我们希望 $\langle G,\Delta W\rangle_F$ 尽可能小。如果不限制更新幅度,只要不断放大反方向的更新,线性近似下的损失就会不断下降。当更新幅度很大时,一阶近似通常不再准确,实际损失可能上升,训练也可能出现不稳定。因此,我们还需要规定每一步允许走多远,这需要引入范数约束,使其具有有限的最优解。
范数约束
范数用于衡量向量或矩阵的大小,不同范数衡量大小的方式不同。例如,对于矩阵更新 $\Delta W$,我们可以规定: \(\begin{equation} \|\Delta W\|_F\leq \eta \end{equation}\) 也可以规定: \(\begin{equation} \|\Delta W\|_2\leq \eta \end{equation}\) 这里,$\eta$ 是允许的更新幅度,$|\cdot|_F$ 是 Frobenius 范数,$|\cdot|_2$ 在矩阵场景下表示谱范数。两种约束衡量的是不同的矩阵性质,因此会允许不同形态的更新。
顺便回顾一下,矩阵的谱范数(Spectral Norm)用一句话来概括,就是矩阵的最大拉伸倍数。矩阵 $A$ 乘一个向量 $x$,本质上是把这个向量旋转并拉伸。因为矩阵在不同方向上的拉伸能力不同,有些方向拉伸得多,有些方向拉伸得少。矩阵 $A$ 的谱范数,就是它能对一个单位向量产生的最大长度。数学定义式如下: \(\begin{equation} \|A\|_2 = \max_{x \ne 0} \frac{\|Ax\|}{\|x\|} \end{equation}\) 考虑 SVD $A = U \Sigma V^\top$,其中:
- $V^\top$ 是旋转,不改变长度。
- $U$ 是旋转,不改变长度。
- $\Sigma$ 是纯拉伸,它的对角线元素 $\sigma_1, \sigma_2, \dots$ 就是各个方向上的拉伸倍数(奇异值)。
所以,矩阵 $A$ 的谱范数,本质上就是它最大的那个奇异值: \(\begin{equation} \|A\|_2 = \sigma_{\max} \end{equation}\) 最速下降
把上述目标写成优化问题: \(\begin{equation} \Delta W^* = \arg\min_{\|\Delta W\|\leq\eta} \langle G,\Delta W\rangle_F \end{equation}\) 这就是范数约束下的最速下降(steepest descent)。
不同范数约束下的最速下降方向
选择不同的范数,就可能得到不同的最速下降方向。根据前面推导,参数更新引起的损失一阶变化为: \(\begin{equation} \Delta L\approx\langle G,\Delta W\rangle_F \end{equation}\) 其中 $G=\nabla L(W)$ 是梯度矩阵。为了让损失下降最多,需要求解: \(\begin{equation} \min_{\Delta W}\langle G,\Delta W\rangle_F \quad \text{s.t.}\quad \|\Delta W\|\leq\eta \end{equation}\) 这里,$\eta$ 是允许的更新幅度。下面只改变范数约束,观察最优解如何变化。
(1) Frobenius 范数约束
约束条件为: \(\begin{equation} \|\Delta W\|_F\leq\eta \end{equation}\) 前面提到过,Frobenius 内积 $\langle G,\Delta W\rangle_F$ 的计算方式是把两个矩阵对应位置的元素相乘,然后全部加起来,它衡量了梯度方向与更新方向的对齐程度。如果两者方向一致,内积为正;如果方向相反,内积为负。Frobenius 内积满足柯西—施瓦茨不等式: \(\begin{equation} \langle G,\Delta W\rangle_F \geq-\|G\|_F\|\Delta W\|_F \end{equation}\) 结合约束可得: \(\begin{equation} \langle G,\Delta W\rangle_F \geq-\eta\|G\|_F \end{equation}\) 当 $\Delta W$ 与 $G$ 方向相反,并且更新的 Frobenius 范数恰好等于 $\eta$ 时能够取到这个最小值,即: \(\begin{equation} \Delta W^*=-\eta\frac{G}{\|G\|_F} \end{equation}\) 因此,最速下降方向为: \(\begin{equation} -\frac{G}{\|G\|_F} \end{equation}\) 直观理解就是把梯度矩阵整体归一化,再沿相反方向更新。
(2) 元素级无穷范数约束
这里的约束是: \(\begin{equation} \|\Delta W\|_\infty =\max_{i,j}|\Delta W_{ij}| \leq\eta \end{equation}\) 它限制的是每个参数的更新幅度 $-\eta\leq\Delta W_{ij}\leq\eta$,而目标函数可以展开为: \(\begin{equation} \langle G,\Delta W\rangle_F =\sum_{i,j}G_{ij}\Delta W_{ij} \end{equation}\) 这里每一项都可以独立选择 $\Delta W_{ij}$。
- 如果 $G_{ij}>0$,为了让乘积尽可能小,取 $\Delta W_{ij}=-\eta$。
- 如果 $G_{ij}<0$,为了让乘积尽可能小,取 $\Delta W_{ij}=+\eta$。
- 如果 $G_{ij}=0$,该元素的更新不影响这个一阶目标。
因此: \(\begin{equation} \Delta W^*=-\eta\operatorname{sign}(G) \end{equation}\) 其中,$\operatorname{sign}(G)$ 表示对矩阵每个元素分别取符号。所以最速下降方向就是: \(\begin{equation} -\operatorname{sign}(G) \end{equation}\) 因此,当约束要求每个参数的变化幅度都不能超过同一个上限时,每个参数都选择自己允许的、最有利于降低损失的方向。
(3) 矩阵谱范数约束
这一项与 Muon 最相关,假设梯度矩阵的奇异值分解为 $G=U\Sigma V^\top$,其中 $\Sigma=\operatorname{diag}(\sigma_1,\ldots,\sigma_r)$,谱范数约束为: \(\begin{equation} \|\Delta W\|_2\leq\eta \end{equation}\) 谱范数衡量矩阵对输入向量的最大放大倍数。要解决: \(\begin{equation} \min_{\|\Delta W\|_2\leq\eta} \langle G,\Delta W\rangle_F \end{equation}\) 利用梯度的奇异值分解有: \(\begin{equation} \begin{aligned} \langle G,\Delta W\rangle_F &=\operatorname{tr}(G^\top\Delta W) \\ &= \operatorname{tr}(V\Sigma U^\top \Delta W)\\ &=\operatorname{tr} \left(\Sigma U^\top\Delta W V\right) \end{aligned} \end{equation}\) 上述推导使用到了如下性质:① 由于 $\Sigma$ 是对角矩阵,所以 $\Sigma^\top = \Sigma$;② 对于任意两个矩阵 $A$ 和 $B$,只要它们能相乘构成方阵,则矩阵的迹具有迹的循环性质,即 $\operatorname{tr}(AB) = \operatorname{tr}(BA)$。
由于 $|\Delta W|_2\leq\eta$,$U$ 和 $V$ 是正交矩阵,不改变矩阵的谱范数,因此 $|U^\top\Delta W V|_2 \leq\eta$。这里用到一个结论:对于任一矩阵的某个对角线元素,它的绝对值不会超过矩阵的最大奇异值。因此有: \(\begin{equation} \left(U^\top\Delta W V\right)_{ii} \geq-\eta \end{equation}\) 因此: \(\begin{equation} \begin{aligned} \langle G,\Delta W\rangle_F &= \operatorname{tr} \left(\Sigma U^\top\Delta W V\right)\\ &= \sum_{i} \sigma_i \cdot (U^\top\Delta W V)_{ii}\\ &\geq-\eta\sum_{i}\sigma_i \\ &=-\eta\|G\|_* \end{aligned} \end{equation}\) 其中,$|G|_*$ 是核范数,即所有奇异值之和。为了让内积达到最小,理想情况下,让 $U^\top\Delta W V$ 这个矩阵的对角线全部填满 $-\eta$,非对角线全 0 即可,即 $U^\top\Delta W V = -\eta I$,可得: \(\begin{equation} \Delta W^*=-\eta UV^\top \end{equation}\) 可以验证,因为 $UV^\top$ 的所有非零奇异值均为 1,所以 $|\Delta W^*|_2=\eta$ 满足约束。并且: \(\begin{equation} \begin{aligned} \langle G,\Delta W^*\rangle_F &=-\eta\langle U\Sigma V^\top,UV^\top\rangle_F \\ &= -\eta \operatorname{tr}\left( (U \Sigma V^\top)^\top (UV^\top)\right) \\ &= -\eta \operatorname{tr}(V \Sigma U^\top UV^\top) \\ &= -\eta \operatorname{tr}(V \Sigma V^\top) \\ &= -\eta \operatorname{tr}(\Sigma V^\top V) \\ &= -\eta \operatorname{tr}(\Sigma) \\ &=-\eta\sum_{i=1}^{r}\sigma_i \\ &=-\eta\|G\|_* \end{aligned} \end{equation}\) 这恰好达到前面推导的最小值。因此最速下降方向为: \(\begin{equation} -UV^\top \end{equation}\) 这就是 Muon 的核心数学联系:在谱范数约束下,梯度矩阵的最速下降方向可以通过奇异值分解得到 $-UV^\top$,而 Muon 使用牛顿—舒尔茨迭代近似计算这一方向。
三种约束对比如下表所示:
| 范数约束 | 最速下降方向 | 核心含义 |
|---|---|---|
| Frobenius 范数 | $-G/|G|_F$ | 控制矩阵整体的平方和 |
| 元素级无穷范数 | $-\operatorname{sign}(G)$ | 分别控制每个元素的变化幅度 |
| 矩阵谱范数 | $-UV^\top$ | 控制矩阵对输入向量的最大放大倍数 |
从这一视角来看,Muon 与 Adam 之间的差异,可以理解为范数约束之间的差异。Adam 的最速下降过程采用一种基于 Max-of-Max 范数动态调整的范数约束,其更新机制具有逐参数自适应的特点,其范数视角强调元素级的尺度控制。而 Muon 提供的范数约束则位于某个较大 $p$ 值所对应的 Schatten-$p$ 范数的一个静态范围内。Schatten-$p$ 范数是一类专门用于衡量矩阵大小的范数,其定义基于矩阵的奇异值。如果矩阵 $A$ 的奇异值为 $\sigma_1,\sigma_2,\ldots,\sigma_r$,那么: \(\begin{equation} \|A\|_{S_p} = \left(\sum_{i=1}^{r}\sigma_i^p\right)^{1/p} \end{equation}\) 不同的 $p$ 值对应不同的矩阵衡量方式:
| 范数 | 定义 | 直观含义 |
|---|---|---|
| Schatten-$1$ 范数 | $\sum_i \sigma_i$ | 奇异值之和,称为核范数 |
| Schatten-$2$ 范数 | $\sqrt{\sum_i \sigma_i^2}$ | 等于 Frobenius 范数 |
| Schatten-$p$ 范数,$p$ 较大 | $(\sum_i\sigma_i^p)^{1/p}$ | 更加关注最大的奇异值 |
| Schatten-$\infty$ 范数 | $\max_i\sigma_i$ | 等于谱范数 |
当 $p$ 越来越大时,最大的奇异值对结果的影响越来越突出。在 $p\to\infty$ 的极限下,Schatten-$p$ 范数收敛到谱范数。因此,Muon 采用较大 $p$ 值对应的 Schatten-$p$ 范数,它从矩阵整体的奇异值结构出发衡量更新幅度,并在精确正交化的情况下对应谱范数。
此外,从神经网络权重的角度来看,权重矩阵本身是一个线性算子,以一个线性层为例 $y=Wx$,其中 $x$ 是输入向量或上一层的隐藏状态,$W$ 是权重矩阵,$y$ 是输出向量。矩阵 $W$ 的作用,是将一个向量映射到另一个向量空间。因此,我们可以研究:输入向量发生变化时,矩阵会如何改变它的长度。
诱导算子范数(induced operator norm)是根据输入空间和输出空间的向量范数,定义矩阵的大小: \(\begin{equation} \|W\|_{X\to Y} = \max_{x\ne0} \frac{\|Wx\|_Y}{\|x\|_X} \end{equation}\) 它衡量矩阵从输入空间到输出空间的最大放大能力。当输入和输出空间都使用欧几里得范数,也就是常见的向量 $L_2$ 范数时: \(\begin{equation} \|W\|_{2\to2} = \max_{x\ne0}\frac{\|Wx\|_2}{\|x\|_2} \end{equation}\) 这个范数恰好等于矩阵的谱范数 $|W|_{2\to2}=|W|_2$。因此,谱范数就是欧几里得空间之间的线性算子所对应的诱导算子范数。而矩阵的谱范数等于其最大奇异值 $|W|_2=\sigma_{\max}(W)$,这意味着,谱范数能够直接衡量一个线性层对任意输入向量的最大放大倍数。
在优化过程中,权重矩阵会从 $W$ 更新为: \(\begin{equation} W'=W+\Delta W \end{equation}\) 对于同一个输入 $x$,更新前后的输出分别为: \(\begin{equation} y=Wx,\quad y'=(W+\Delta W)x \end{equation}\) 因此,输出变化为: \(\begin{equation} \Delta y=y'-y=\Delta W x \end{equation}\) 根据谱范数的定义有: \(\begin{equation} \|\Delta y\|_2 \leq\|\Delta W\|_2\|x\|_2 \end{equation}\) 这个公式把谱范数与优化器的更新过程直接联系起来,限制更新矩阵 $\Delta W$ 的谱范数,可以控制这次权重更新对任意输入向量造成的最大输出变化。这为谱范数约束提供了自然的几何解释。神经网络权重承担着线性变换的功能,采用诱导算子范数可以直接描述这种变换对输入的影响。基于这一考虑,Muon 所采用的范数约束比 Adam 所对应的范数约束更符合神经网络权重矩阵作为线性算子的结构特点。
(二)Muon 的规模扩展
1. 权重衰减
尽管 K. Jordan 等人的研究表明,Muon 在小规模训练中显著优于 AdamW,但本文发现,随着模型规模扩大、训练 token 数量增加,其性能优势逐渐减弱。本文观察到,模型权重和各层输出的均方根(Root Mean Square,RMS)都持续增长到较大的数值,超出了 bf16 的高精度表示范围,这可能损害模型的性能。为了解决这一问题,本文将 AdamW 中的标准权重衰减机制引入 Muon。 \(\begin{equation} W_t=W_{t-1}-\eta_t(O_t+\lambda W_{t-1}) \label{eq:update} \end{equation}\) 论文分别对使用和不使用权重衰减的 Muon 进行了实验,以了解权重衰减对大语言模型训练动态的影响。根据对缩放定律的研究,本文使用 800M 参数的模型进行了实验,训练数据量为 100B tokens(约为最优训练 token 数量的 5 倍)。下图展示了分别使用 AdamW、原始 Muon(不使用权重衰减)和使用权重衰减的 Muon 训练时的验证损失曲线。尽管原始 Muon 在初期收敛更快,但随着训练持续进行,部分模型权重变得过大,这可能限制模型的长期性能。引入权重衰减解决了这一问题。实验结果表明,在过度训练阶段,使用权重衰减的 Muon 优于原始 Muon 和 AdamW,取得了更低的验证损失。因此,本文将更新规则调整为公式 $\eqref{eq:update}$,其中 $\lambda$ 为权重衰减系数。

2. 一致的更新 RMS
Adam 和 AdamW 的一个重要性质是,它们能够使理论更新 RMS 保持在约 1 的水平。然而,Muon 的更新 RMS 会随参数矩阵的形状而变化,具体如下:
引理 1。 对于形状为 $[A,B]$ 的满秩矩阵参数,其理论 Muon 更新 RMS 为 $\sqrt{\frac{1}{\max(A,B)} }$。
这里的 $A$ 和 $B$ 指的是矩阵的行和列。
证明如下:
不失一般性,考虑正交矩阵 $U\in\mathbb{R}^{n\times n}$ 和 $V\in\mathbb{R}^{m\times m}$,其中 $n\geq m\geq r$。我们将证明,对于 $X=U_{[:,\, :r]}V_{[:r,\, :]}$,其均方根值为 $\operatorname{RMS}(X)=\sqrt{\frac{r}{mn} }$。根据矩阵乘法的定义: \(\begin{equation} X_{i,j}=\sum_{k=1}^{r}U_{i,k}V_{k,j} \label{eq:xij} \end{equation}\) 矩阵 $X \in \mathbb{R}^{n \times m}$,其 RMS 可以表示为: \(\begin{equation} \operatorname{RMS}(X) = \sqrt{\frac{1}{mn} \sum_{i=1}^{n}\sum_{j=1}^{m}X_{i,j}^2} \end{equation}\) 两边平方: \(\begin{equation} \operatorname{RMS}(X)^2 = \frac{1}{mn} \sum_{i=1}^{n}\sum_{j=1}^{m}X_{i,j}^2 \end{equation}\) 这里的 $1/mn$ 表示对矩阵全部 $mn$ 个元素取平均。将公式 $\eqref{eq:xij}$ 代入上式,有: \(\begin{equation} \operatorname{RMS}(X)^2 = \frac{1}{mn} \sum_{i=1}^{n}\sum_{j=1}^{m} \left(\sum_{k=1}^{r}U_{i,k}V_{k,j}\right)^2 \end{equation}\) 展开平方: \(\begin{equation} \operatorname{RMS}(X)^2 ={}\frac{1}{mn} \sum_{k=1}^{r}\sum_{l=1}^{r} \left(\sum_{i=1}^{n}U_{i,k}U_{i,l}\right) \left(\sum_{j=1}^{m}V_{k,j}V_{l,j}\right) \end{equation}\) 由于 $U_{[:,\, :r]}$ 的列向量和 $V_{[:r,\, :]}$ 的行向量分别正交归一,因此: \(\begin{equation} \sum_{i=1}^{n}U_{i,k}U_{i,l} = \begin{cases} 1,&k=l\\ 0,&k\ne l \end{cases} \end{equation}\) 同理: \(\begin{equation} \sum_{j=1}^{m}V_{k,j}V_{l,j} = \begin{cases} 1,&k=l\\ 0,&k\ne l \end{cases} \end{equation}\) 因此,当 $k\ne l$ 时,对应的交叉项为零;当 $k=l$ 时,每一项的乘积为 1。总共存在 $r$ 个这样的非零项,于是: \(\begin{equation} \operatorname{RMS}(X)^2 = \frac{1}{mn}\sum_{k=1}^{r}1 = \frac{r}{mn} \end{equation}\) 因此: \(\begin{equation} \operatorname{RMS}(X)=\sqrt{\frac{r}{mn} } \end{equation}\) 对于矩阵满秩这一常见情况,有 $r=m$,因此: \(\begin{equation} \operatorname{RMS}(X)=\sqrt{\frac{1}{n} } \end{equation}\)
通过在训练过程中监测 Muon 的更新 RMS,发现其通常接近上述理论值。这种理论更新 RMS 在扩大模型规模时可能带来问题:
- 当 $\max(A,B)$ 过大时,例如稠密 MLP 矩阵,参数更新会变得过小,从而限制模型的表征能力,导致性能不理想。
- 当 $\max(A,B)$ 过小时,例如将 GQA 或 MLA 中的每个 KV 头分别作为独立参数处理时,参数更新会变得过大,从而导致训练不稳定,同样造成性能不理想。
为了使不同形状的矩阵具有一致的更新 RMS,本文提出将 Muon 对每个矩阵的更新乘以 $\sqrt{\max(A,B)}$,以抵消引理 1 中所描述的影响。后续实验表明,这一策略有利于优化。
3. 匹配 AdamW 的更新 RMS
Muon 专为矩阵形式的参数更新而设计。在实际应用中,通常将 AdamW 与 Muon 结合使用,由 AdamW 处理非矩阵形式的参数,例如 RMSNorm、LM head 和 embedding 参数。我们希望矩阵参数和非矩阵参数能够共享优化器超参数,包括学习率 $\eta$ 和权重衰减系数 $\lambda$。
因此,本文提出将 Muon 的更新 RMS 调整到与 AdamW 相近的水平。根据经验观察,AdamW 的更新 RMS 通常在 0.2 到 0.4 之间。因此,本文通过以下调整,将 Muon 的更新 RMS 缩放到这一范围: \(\begin{equation} W_t=W_{t-1} -\eta_t\left( 0.2\cdot O_t\cdot\sqrt{\max(A,B)} +\lambda W_{t-1} \right) \end{equation}\) 通过实验结果验证了这一选择。此外,采用这一调整后,Muon 可以直接复用针对 AdamW 调优的学习率和权重衰减系数。
4. 其他超参数
Muon 还包含另外两个可调超参数:牛顿—舒尔茨迭代步数 $N$ 和动量系数 $\mu$。实验观察表明,将 $N$ 设置为 10,相比设置为 5,能够得到更精确的正交化结果,但并未带来更好的模型性能。因此,出于效率考虑,本工作将 $N$ 设置为 5。在调整动量系数时,没有观察到稳定一致的性能提升,因此选择与 K. Jordan 等人相同的设置,即 $\mu=0.95$。
(三)分布式 Muon
1. ZeRO-1 与 Megatron-LM
ZeRO-1 技术将开销较大的优化器状态(例如主权重和动量)分区并分配到整个集群中的各个设备上。Megatron-LM 将 ZeRO-1 集成到了其原生的并行设计中。基于 Megatron-LM 的多种高级并行策略,例如张量并行(Tensor Parallelism,TP)、流水线并行(Pipeline Parallelism,PP)、专家并行(Expert Parallelism,EP)和数据并行(Data Parallelism,DP),ZeRO-1 的通信开销可以从需要在整个分布式集群中进行数据收集,降低为只需要在数据并行组内进行数据收集。
2. 分布式 Muon 的实现
ZeRO-1 对 AdamW 非常高效,因为 AdamW 以逐元素的方式计算参数更新。然而,Muon 需要完整的梯度矩阵来计算更新。因此,原始的 ZeRO-1 无法直接应用于 Muon。
本文提出一种基于 ZeRO-1 的 Muon 分布式解决方案,称为 Distributed Muon。Distributed Muon 遵循 ZeRO-1 的设计,在数据并行组内对优化器状态进行分区。与原始的基于 ZeRO-1 的 AdamW 优化器相比,它额外引入了两项操作:
- DP Gather。 对于本地分区的主权重(其大小为模型权重的 $1/DP$),该操作用于将对应的分区梯度收集起来,恢复为完整的梯度矩阵。
- 计算完整更新。 完成上述收集后,对完整的梯度矩阵执行牛顿—舒尔茨迭代。需要注意的是,随后会丢弃完整更新矩阵中的部分内容,因为实际执行参数更新时,只需要保留与本地参数对应的分区。
Distributed Muon 的实现如算法 1 所示。该算法额外引入的操作以蓝色标出。

这里为什么额外引入的是 Gather 而不是 All Gather?首先区分两种操作:
- Gather:将多张 GPU 上的数据分片收集到指定的一张 GPU,只有接收端获得完整数据。
- All-Gather:将多张 GPU 上的数据分片收集并分发给所有 GPU,使每张 GPU 都获得完整数据。
对于 Distributed Muon,关键在于 ZeRO-1 对优化器状态的分片方式,ZeRO-1 并不一定把每个矩阵切分到所有 GPU。以两张 GPU 和五个权重矩阵 $W_0,\ldots,W_4$ 为例,ZeRO-1 可以将优化器状态拼接成一个大数组,再按照 GPU 数量切分。假设分片结果如下:
- GPU 0:$M_0$ 完整;$M_1$ 完整;$M_2$ 前半;
- GPU 1:$M_2$ 后半;$M_3$ 完整;$M_4$ 完整。
其中 $M_i$ 表示各权重矩阵对应的动量状态。Muon 只需要收集被切开的矩阵,在这个例子中:
- GPU 0 可以直接对 $M_0,M_1$ 执行 NS 迭代,只需向 GPU 1 收集 $M_2$ 的后半部分。
- GPU 1 可以直接对 $M_3,M_4$ 执行 NS 迭代,只需向 GPU 0 收集 $M_2$ 的前半部分。
- 两张 GPU 都会对完整的 $M_2$ 进行 NS 计算,然后分别保留自己负责的更新分片。
因此,额外通信仅涉及跨 GPU 边界被切分的矩阵。已经完整位于某张 GPU 上的矩阵,无需额外收集。因此 DP Gather 强调按需收集本地更新所涉及的矩阵分片,而非对全部优化器状态执行一次全局 All Gather。具体可以参考:Question about Distributed Muon · Issue #16 · MoonshotAI/Moonlight
3. 分析
将 Distributed Muon 与经典的基于 ZeRO-1 的分布式 AdamW(以下简称 Distributed AdamW)进行比较如下:
-
内存使用。 Muon 只使用一个动量缓冲区(梯度动量),而 AdamW 使用两个动量缓冲区(一阶矩、二阶矩)。因此,Muon 优化器额外使用的内存只有 Distributed AdamW 的一半。
-
通信开销。 对于每个设备,额外的 DP Gather 操作只针对本地数据并行分区参数 $p$ 执行。因此,其通信开销小于对完整梯度 $G$ 执行 Reduce-Scatter 或对更新后的参数 $P$ 执行 All-Gather 的通信开销。此外,Muon 只需要以 bf16 精度执行牛顿—舒尔茨迭代,因此,与 fp32 相比,相关通信开销进一步降低至 50%。
总体而言,Distributed Muon 的通信开销是 Distributed AdamW 的 $(1,1.25]$ 倍。上界的计算方式如下:
- Distributed Muon:4(以 fp32 精度对 $G$ 执行 Reduce-Scatter)+ 2(以 bf16 精度执行 Muon 的 Gather)+ 4(以 fp32 精度对 $P$ 执行 All-Gather)。
-
Distributed AdamW:4 + 4。
在实际训练中,由于通常使用多个数据并行组,实测的额外通信开销通常更接近下界 1 倍。如果启用了张量并行(TP),Distributed Muon 还需要在张量并行组内额外执行一次 bf16 精度的 TP Gather。
-
延迟。 由于引入了额外的通信操作,并且需要执行牛顿—舒尔茨迭代,Distributed Muon 的端到端延迟高于 Distributed AdamW。然而,这并不是一个显著的问题,原因有两点:
(a)为了获得良好的结果,只需要执行约 5 次牛顿—舒尔茨迭代。
(b)与模型前向传播和反向传播所需的时间相比,优化器造成的端到端延迟可以忽略不计,例如通常只占 1% 至 3%。
此外,一些工程技术还可以进一步降低延迟,例如将数据收集与计算重叠执行,以及将优化器的 Reduce-Scatter 与参数收集操作重叠执行。
在分布式集群中训练大规模模型时,与相应的 AdamW 实现相比,Distributed Muon 没有产生明显的延迟开销。
三、实验
(一)一致的更新 RMS
如前所述,经过一系列操作使得所有矩阵参数的更新 RMS 保持一致,并使其与 AdamW 的更新 RMS 相匹配。实验中,本文尝试了两种控制不同参数之间 Muon 更新 RMS 的方法,并将它们与一种基线方法进行了比较:
- Baseline。将更新矩阵乘以 $0.2\cdot\sqrt{H}$,其中 $H$ 为模型的隐藏维度,以使更新 RMS 与 AdamW 保持一致。需要注意的是,对于大多数矩阵,$\max(A,B)=H$。
- Update Norm。可以直接对通过牛顿—舒尔茨迭代计算得到的更新进行归一化,使其 RMS 严格等于 $0.2$:
- Adjusted LR。对于每个更新矩阵,可以根据其形状,将学习率缩放一个 $0.2\cdot\sqrt{\max(A,B)}$ 的因子。
先前观察到,在更大规模的模型训练中,异常行为会很快出现。因此本文通过设计实验来观察训练早期 Muon 更新 RMS 的影响,使用先前所述的 800M 参数小规模模型进行了实验。当矩阵维度之间的差异增大时,更新 RMS 不一致的问题会更加明显。为了突出这一问题并进一步研究,本文对模型架构进行了轻微修改,将 SwiGLU MLP 替换为标准的两层 MLP,使其矩阵参数的形状从 $[H,2.6H]$ 变为 $[H,4H]$。
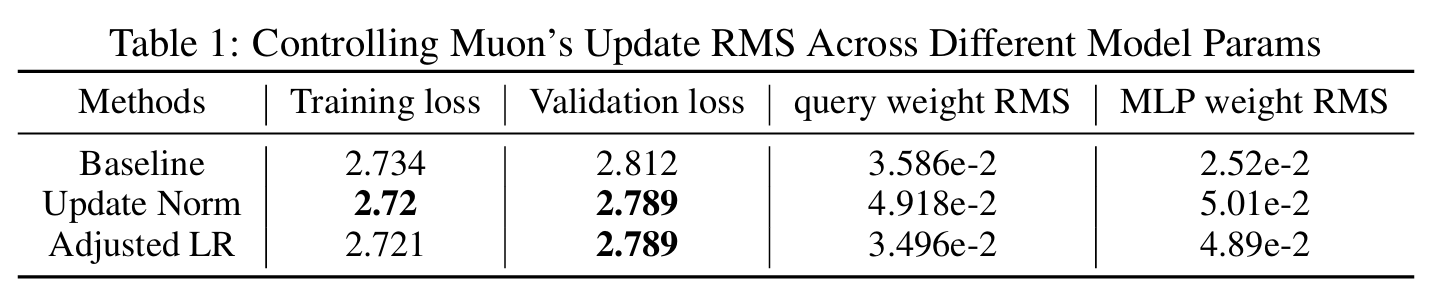
本文评估了模型的损失,并监测了部分参数的 RMS,具体包括 Attention Query(形状为 $[H,H]$)和 MLP 权重(形状为 $[H,4H]$)。在模型按照总计 20B 个 token 的训练计划完成 4B 个 token 的训练后,对模型进行了评估。从表 1 中,能够观察到以下几个有趣的现象:
- Update Norm 和 Adjusted LR 两种方法均取得了优于 Baseline 的性能。
-
对于形状为 $[H,4H]$ 的 MLP 权重矩阵,Update Norm 和 Adjusted LR 两种方法得到的权重 RMS 均约为 Baseline 的两倍。这是合理的,因为 $\frac{\sqrt{\max(H,4H)} }{\sqrt H}=2$,因此,Update Norm 和 Adjusted LR 的更新 RMS 约为 Baseline 的两倍。
- 对于形状为 $[H,H]$ 的注意力查询权重矩阵,Update Norm 仍然会对更新进行归一化,而 Adjusted LR 不会,因为 $\frac{\sqrt{\max(H,H)} }{\sqrt H}=1$,因此,Adjusted LR 得到的权重 RMS 与 Baseline 相近,而 Update Norm 得到的权重 RMS 更大,与其 MLP 权重的 RMS 相近。
基于这些发现,在后续实验中选择了 Adjusted LR 方法,因为它的计算开销更低。
(二)Muon 的扩展定律
为了与 AdamW 进行公平比较,本文在一系列采用 Llama 架构的稠密模型上进行了扩展定律实验。在优化器研究中,建立一个强有力的基线至关重要。因此,本文按照计算最优训练设置,对 AdamW 的超参数进行了网格搜索,模型架构和超参数的详细信息见表 2。对于 Muon,由于将 Muon 的更新 RMS 调整到了与 AdamW 相匹配的水平,因此直接复用了针对 AdamW 基线所确定的最优超参数。

拟合得到的缩放定律曲线见下图,拟合方程详见表 3。在计算最优设置下,Muon 只需要约 52% 的训练 FLOPs,即可达到 AdamW 的性能水平。


(三)使用 Muon 进行预训练
模型架构
为了评估 Muon 在当代模型架构上的表现,采用 DeepSeek-V3-Small 架构从头开始进行预训练,因为该架构展现出了较强的性能,且其原始实验结果可以作为比较基准。预训练的模型具有 2.24B 激活参数和 15.29B 总参数(若计入 embedding,则分别为 3B 激活参数和 16B 总参数)。
预训练数据
预训练数据的详细信息见 Kimi k1.5: Scaling Reinforcement Learning with LLMs。预训练期间的最大上下文长度为 8K。
预训练
模型分多个阶段进行训练。在第 1 阶段和第 2 阶段,使用 $10^{-3}$ 的无辅助损失偏置更新率;在第 3 阶段,该更新率设为 0.0。所有阶段的权重衰减系数均设为 0.1。
- 0 至 33B tokens:在这一阶段,学习率在 2000 步内线性增加至 $4.2\times10^{-4}$。批次大小保持为 2048 个样本。
- 33B 至 5.2T tokens:在这一阶段,学习率按照余弦策略从 $4.2\times10^{-4}$ 衰减至 $4.2\times10^{-5}$。在训练 token 数量达到 200B 之前,批次大小保持为 2048;此后,批次大小增加到 4096,并在剩余训练过程中保持不变。
- 5.2T 至 5.7T tokens:这一阶段也称为冷却阶段。学习率在 100 步内升至 $10^{-4}$,随后在接下来的 500B tokens 训练过程中线性衰减至 0,批次大小始终保持为 4096。在这一阶段,使用质量最高的数据,重点关注数学、代码和推理任务。
评测基准
评测涵盖四大类基准测试,每一类都旨在评估模型的不同能力。
- 英语语言理解与推理: MMLU(5-shot)、MMLU-Pro(5-shot)、BBH(3-shot)、TriviaQA(5-shot);
- 代码生成: HumanEval(pass@1)、MBPP(pass@1);
- 数学推理: GSM8K(4-shot)、MATH、CMATH;
- 中文语言理解与推理: C-Eval(5-shot)、CMMLU(5-shot)。
性能
将使用 Muon 训练的模型命名为 Moonlight。将 Moonlight 与规模相近的不同公开模型进行了比较。首先,评估了训练至 1.2T tokens 时的 Moonlight,并将其与以下架构相同、训练 token 数量相近的模型进行比较:
- DeepSeek-V3-Small:一个具有 2.4 B 激活参数和 16B 总参数的 MoE 模型,使用 1.33T tokens 进行训练。
- Moonlight-A: 与 Moonlight 采用相同的训练设置,但使用 AdamW 优化器。
对于 Moonlight 和 Moonlight-A,使用了总计 5.7T tokens 预训练过程中的 1.2T tokens 检查点。此时,学习率尚未衰减至最低值,模型也尚未进入冷却阶段。

如表 4 所示,使用 AdamW 训练的基线模型 Moonlight-A,与规模相近的公开模型相比,表现出了较强的性能。Moonlight 的表现显著优于 Moonlight-A,证明了 Muon 在规模扩展方面的有效性。此外观察到,Muon 在数学和代码相关任务上尤其出色,并鼓励研究社区进一步研究这一现象。
在 Moonlight 完成全部 5.7T tokens 的训练后,将其与规模相近的公开模型进行了比较,结果如表 5 所示:
- Llama3-3B:一个具有 3B 参数的稠密模型,使用 9T tokens 进行训练。
-
Qwen2.5-3B:一个具有 3B 参数的稠密模型,使用 18T tokens 进行训练。
- DeepSeek-V2-Lite:一个具有 2.4B 激活参数和 16B 总参数的 MoE 模型,使用 5.7T tokens 进行训练。

如表 5 所示,Moonlight 的表现优于采用相似架构且训练词元数量相当的模型。即使与使用了规模大得多的数据集进行训练的稠密模型相比,Moonlight 仍然保持了具有竞争力的性能。值得注意的是,Moonlight 位于模型性能与训练预算之间的帕累托前沿上,在不同模型规模的比较中,其表现优于许多其他模型。
(四)奇异值谱的动态变化
为了验证 Muon 能够沿着更多样化的方向优化权重矩阵这一直觉,对使用 Muon 和 AdamW 训练得到的权重矩阵进行了谱分析。对于一个奇异值为 $\sigma=(\sigma_1,\sigma_2,\cdots,\sigma_n)$ 的权重矩阵,按照以下公式计算该矩阵的 SVD entropy: \(\begin{equation} H(\sigma)= -\frac{1}{\log n} \sum_{i=1}^{n} \frac{\sigma_i^2}{\sum_{j=1}^{n}\sigma_j^2} \log\frac{\sigma_i^2}{\sum_{j=1}^{n}\sigma_j^2} \end{equation}\) 如下图所示,展示了使用 1.2T tokens 进行预训练期间,不同训练检查点中权重矩阵的平均奇异值分解熵。可以看到,在所有训练检查点和所有权重矩阵类别中,Muon 的奇异值分解熵均高于 AdamW。这验证了我们的直觉:Muon 能够为权重矩阵提供更多样化的更新谱。这一差异在用于选择专家的 Router 权重中更加显著,这表明 MoE 可能从 Muon 中获益更多。
此外,实验发现超过 90% 的权重矩阵,使用 Muon 优化时的奇异值分解熵高于使用 AdamW 优化时的结果。这为 Muon 在探索多样化优化方向方面具有更强的能力提供了有力的实验证据。

统计时,将权重矩阵分为以下 6 类:
- AttnQO: 注意力层中与查询投影和输出投影相关的权重矩阵;
- AttnKV: 注意力层中与键投影和值投影相关的权重矩阵;
- Experts: 专家模型中的权重矩阵;
- SharedExperts: 共享专家模型中的权重矩阵;
- Router: 路由器中的权重矩阵;
- Dense: 第一个稠密层中的权重矩阵。
奇异值分解熵采用宏平均计算,即对所有层中每个类别的权重矩阵进行平均。对于专家模型中的权重,为提高计算效率,在不同层中仅选取 64 个专家中的 3 个进行计算。
(五)使用 Muon 进行监督微调
本节针对大语言模型训练中的标准监督微调阶段,对 Muon 优化器进行了消融实验。研究结果表明,Muon 带来的优势在监督微调阶段依然存在。具体而言,同时使用 Muon 进行预训练和微调的模型,在消融实验中优于其他模型。然而,本文也观察到,当监督微调阶段使用的优化器与预训练阶段不同时,使用 Muon 进行监督微调并未表现出相对于 AdamW 的显著优势。
预训练与监督微调优化器之间的可互换性研究
为了进一步研究 Muon 的潜力,分别使用 Muon 和 AdamW 优化器,对 Moonlight@1.2T 和 Moonlight-A@1.2T 进行了微调。这些模型在开源数据集 tulu-3-sft-mixture 上进行了两个训练轮次的微调,该数据集包含序列长度为 4K 的数据。学习率采用线性衰减策略,从 $5\times10^{-5}$ 开始,逐渐降低至 0。表 6 展示了实验结果,结果突显了 Moonlight@1.2T 相较于 Moonlight-A@1.2T 的优越性能。

在公开预训练模型上使用 Muon 进行监督微调
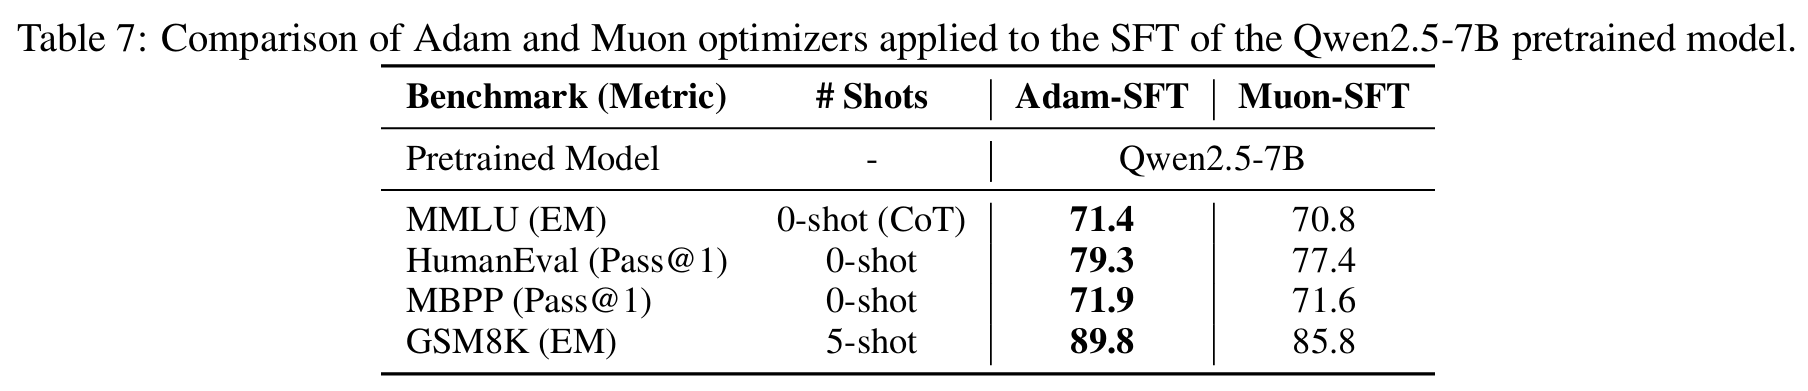
本文进一步将 Muon 应用于公开预训练模型的监督微调,具体使用 Qwen2.5-7B 基础模型,并采用开源数据集 tulu-3-sft-mixture。数据集经过打包处理,序列长度设为 8K。采用余弦学习率衰减策略,学习率从 $2\times10^{-5}$ 开始,逐渐降低至 $2\times10^{-6}$。实验结果见表 7。作为对比,发现使用 Muon 微调的模型取得了与使用 Adam 微调的模型相当的性能。这些结果表明,若要获得最佳性能,在预训练阶段使用 Muon 比在监督微调阶段使用 Muon 更为有效。
四、总结
通过系统的分析与改进,本文成功将 Muon 应用于一个激活参数量为 3B、总参数量为 16B 的 MoE 模型,并使用 5.7T tokens 对其进行了训练。研究结果表明,Muon 能够有效替代 AdamW,成为大规模大语言模型训练中的标准优化器,并在训练效率和模型性能方面展现出显著优势。