【论文解读】 DeepSeek-V4.1-Flash
Categories: Paper
目录
概览
近年来,长程 Agent 的广泛应用使得模型工作负载越来越偏向于输入密集型。尽管先前的研究已经显著降低了长上下文计算的成本,但 prefill 阶段仍然具有较高的计算开销,大规模 KV Cache 仍然持续对 HBM 和 SSD 容量以及数据传输带宽造成压力。这些计算、存储和带宽需求共同成为进一步降低部署成本的主要瓶颈。
为了解决这一挑战,本文提出 DeepSeek-V4.1-Flash,一个支持最长一百万 token 上下文的多模态混合专家模型,其骨干网络参数规模达到 552B。借助其 因果编码器-解码器(Causal Encoder-Decoder, CED)架构,该模型在 decode 阶段每个 token 激活 16B 参数,而在 prefill 阶段仅激活 8B 参数,显著提升了 Agent 工作负载下的成本效率。为了进一步突破 KV Cache 压缩的极限,DeepSeek-V4.1-Flash 将 Compressed Sparse Attention 2(CSA2)中的跨层 KV Cache 复用机制 与 FP4 KV Cache 相结合。这些设计使其全局 KV Cache 占用量(始终驻留于 HBM 中)降低至每 token 890 bytes,约为 DeepSeek-V4-Flash 对应占用量的 1/4。此外,通过一种专门的部署优化方法 SWA Bounded Replay,DeepSeek-V4.1-Flash 将其持久化 KV Cache 占用量(始终存储于 SSD 或主机内存中)进一步降低至 DeepSeek-V4-Flash 的约 1/8。尽管 KV Cache 占用显著降低,该模型仍然相比基线模型取得了更强的性能表现。除此之外,论文进一步简化了 DeepSeek-V4 架构,并引入多个高效的架构扩展。在包含 45T tokens 的多模态语料库上对 DeepSeek-V4.1-Flash 进行预训练,并进行了全面的后训练,使其在多种文本和多模态 Agent 场景中均展现出强大的性能。
原文链接:DeepSeek_V41_Tech_Report.pdf
相关解读:【论文解读】DeepSeek-V4、【论文解读】DeepSeek Engram、【论文解读】DeepSeek mHC
一、模型架构
(一)总览
DeepSeek-V4.1-Flash 是一个多模态混合专家(Mixture-of-Experts,MoE)Transformer,以图像和文本作为输入,并以自回归方式生成文本。其语言骨干网络包含 40 个因果 Transformer 层,由一个 20 层的因果编码器(causal encoder)和一个 20 层的解码器(decoder)依次组成。除最开始的两层仅使用滑动窗口注意力(Sliding-Window Attention,SWA)之外,其余各层均同时包含全局注意力和 SWA。一个视觉编码器(vision encoder)和一个 MLP projector 将图像转换为视觉 embedding,并与文本 embedding 一同交由语言骨干网络处理;多模态数据从语言模型预训练开始阶段就被纳入训练。总体而言,DeepSeek-V4.1-Flash 包含 552B 的 backbone 参数和 196B 的 Engram 参数,在 prefill 阶段每个 token 激活 8B 参数,在 decode 阶段每个 token 激活 16B 参数。下图展示了 DeepSeek-V4.1-Flash 的整体架构。其中,网络被划分为一个因果编码器和一个解码器,两者各包含 20 层。所有前馈层均采用标准 DeepSeekMoE。编码器的前两层使用滑动窗口注意力(SWA),其余层使用 Compressed Sparse Attention 2(CSA2),其中 CSA2(ratio, mode) 表示对应的压缩比例和模式。模型还使用了 Single-Pass mHC、Engram、DSpark 和 Hierarchical Sparse Indexer。

Causal Encoder-Decoder(CED)架构与 Compressed Sparse Attention 2(CSA2)分别针对长上下文推理中的不同成本进行优化。CED 根据 encoder 的输出构建 decoder 的全局 KV Cache,使得绝大多数 prompt token 可以跳过完整的 decoder 计算,同时仍然保留逐层的局部滑动窗口注意力。这样可以将 prefill 计算量降低近一半,尤其是在上下文持续增长的情况下,可以降低 Agent 工作负载中处理新增输入或缓存未命中时的成本。CSA2 在不同层之间共享 global KV,以降低 Cache 存储开销,同时复用稀疏选择结果,以减少索引计算量。在 decoder 中,Hierarchical Sparse Indexer 会将后续 indexer 的搜索范围限制在由更早的 indexer 选出的候选池(candidate pool)中,从而进一步减少每个 query 需要评分的 KV entry 数量。
模型保留了 DeepSeekMoE 中的 shared expert 和细粒度 routed expert,并针对图像 token 和文本 token 引入了模态特定的负载均衡(modality-specific load balancing)。Single-Pass mHC 对 residual stream 的混合方式进行了修改,从而支持更加高效的 Kernel 融合;Engram 则引入了以稀疏方式访问的条件记忆(conditional memory)。不同于以往,这次在 backbone 预训练阶段,移除了 MTP 模块,并使用 DSpark 进行 speculative decoding。DSpark 会在 backbone 预训练阶段完成之后单独进行训练。此外,将 main KV Cache 压缩至 FP4,以进一步降低存储开销。
(二)多模态架构
多模态输入路径由一个视觉编码器(vision encoder)和一个 MLP projector 构成。对于每张输入图像,vision encoder 首先生成一个空间网格形式的视觉特征。随后,用一个 3 × 3 pixel-unshuffle 操作沿 channel 维度重新排列每个局部邻域,从而降低空间分辨率。之后,MLP projector 将这些特征映射到语言 backbone 的隐藏维度。最后,得到的视觉 embedding 会被插入到输入 embedding 序列中对应的 image-token 位置,并由语言 backbone 与文本 embedding 一同进行处理。
1. DeepSeek-ViT
从零训练了一个名为 DeepSeek-ViT 的视觉编码器,使其能够原生处理不同分辨率的图像。DeepSeek-ViT 基于 Vision Transformer 架构构建,并进行了若干修改。为了支持任意分辨率输入,使用 2D-RoPE 替代标准的绝对位置编码。为了使 ViT 的设计更加贴近 LLM 的设计原则,将 patch embedding 层中的卷积替换为线性投影,从而保证其与 Muon optimizer 的兼容性。此外还采用 RMSNorm 进行归一化,并使用 SwiGLU 作为激活函数。在将视觉特征输入 LLM 之前,采用带有 3 × 3 下采样的 pixel-unshuffle 操作,将视觉 token 数量降低至原来的 1/9,从而有效支持最高约 1344 × 1344 像素的输入分辨率。
这里的 3 × 3 pixel-unshuffle 是指,例如原视觉特征为 (h, w, dim),那么经过 3 × 3 pixel-unshuffle 后,变为 (h/3, w/3, dim×3×3),这样空间分辨率降低至原来的 1/9,dim×3×3 后续会被投影到语言骨干的隐藏维度。
2. 多模态无辅助损失负载均衡
图像 token 和文本 token 具有不同的表示分布,因此在 MoE 中可能产生不同的专家路由偏好。如果仅对两种模态合并后的整体负载进行均衡,就可能掩盖某一种模态内部存在的 expert 负载不均衡问题。为了解决这一问题,论文扩展了无辅助损失负载均衡,分别为文本 token 和图像 token 维护各自独立的、按 expert 划分的 correction bias。在 routing 过程中,每个 token 使用与自身模态对应的 correction bias 来进行 expert 选择,而原始的 routing score 仍然用于对所选 expert 的输出进行加权。每完成一个 training step,两组 bias 都会依据各自模态对应的 expert load 独立进行更新。这种设计能够分别在每一种模态内部实现负载均衡,并有助于实现稳定且高效的多模态训练。
(三)Causal Encoder-Decoder (CED)
在 Agent 工作流中,频繁的工具调用会产生大量 prefill 请求,一旦 KV Cache 未命中,就会带来很高的计算开销。为缓解这一 prefill 瓶颈,论文提出 Causal Encoder-Decoder(CED) 架构,其设计受到 YoCo 的启发。YoCo 的核心思路是:允许上层网络直接共享由下层网络生成的 KV Cache,从而降低 prefill 阶段的计算量。在此基础上,CED 进一步引入了一系列结构性改进,以同时提升整体 KV Cache 容量以及 KV 生成过程的计算深度。最终,CED 在保持与基线模型相当性能的同时,将 prefill 计算量降低了接近一半。
对于全局注意力(global attention),CED 将模型底部的 $L/2$ 层视为 causal encoder。对于上半部分的层,也就是 decoder 中满足 $l > \frac{L}{2}$ 的层,其 KV entry 不再由各层自身的 hidden state $H_l$ 生成,而是使用层相关的投影权重($W_l^{KV}$ 和 $W_l^Z$)直接从第 $L/2$ 层的 hidden state $H_{L/2}$ 投影得到: \(\begin{equation} C_l = H_{L/2} W_{l}^{KV}, \qquad Z_l = H_{L/2} W_l^{Z}, \qquad l > \frac{L}{2} \end{equation}\) 其中,$C$ 和 $Z$ 分别表示 KV entry 以及与其对应的压缩权重。该设计使得 CED 能够在 prefill 阶段仅计算前半部分层,从而以极低的计算成本获取上层全局 KV 缓存。
对于滑动窗口注意力(Sliding-Window Attention,SWA),CED 仍然在所有层中保留传统的逐层计算方式。具体来说,对于任意一层 $l$,其局部 key 和 value 都直接由当前层自身的 hidden state $H_l$ 生成,这种设计实际上增加了局部 KV 生成过程的计算深度。问题在于,CED 为了降低 prefill 开销,prompt 的主体只经过前 $L/2$ 层 causal encoder,而不会完整经过后 $L/2$ 层 decoder。因此,decoder 各层所需的 SWA KV 并不会在这一过程中自然生成。为了在 decode 开始前恢复这些局部 KV,就需要引入 SWA replay:将 prompt 尾部的一段 encoder outputs 重新送入 decoder,补充计算各层的 SWA KV。
由于 SWA 的局部依赖会随着 decoder 层数逐层向前传播,经过 $L/2$ 层后,其理论感受野可扩展至约 $n_{\text{win} }\times \frac{L}{2}$,其中 $n_{\text{win} }$ 为 SWA 的窗口大小。因此,如果希望精确重建 decoder 的 SWA KV,理论上需要 replay prompt 尾部约 $n_{\text{win} }\times L/2$ 个 token。对于每轮新增 prompt 较短的多轮交互场景,这部分额外的 decoder 计算开销会变得不可忽略。幸运的是,已有研究(PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention)表明,SWA 的实际有效感受野远小于其理论上的 $n_{\text{win} } \times \frac{L}{2}$,基于这一观察,论文引入了 Decoder SWA Bounded Replay。该方法在进行 SWA 计算时,只对 prompt 最后的 $n_{\text{win} }$ 个 token 执行 prefill,从而显著降低计算成本。
总体而言,当序列长度满足 $N \gg n_{\text{win} }$ 时,CED 将 prefill 的计算复杂度从 $O(NL)$ 降低为 $O\left( \frac{NL}{2} + n_{\text{win} } \times \frac{L}{2} \right) \approx O\left(\frac{NL}{2}\right)$,因此整体 prefill 计算量大约减少一半。
(四)Compressed Sparse Attention 2(CSA2)
服务长上下文需要同时控制 KV Cache 存储开销和注意力计算开销。这两类开销可以沿三个正交的维度进行压缩:第一是 entry size 维度,例如 GQA 通过减少 KV head 的数量来压缩,而 MLA 则在不同 head 之间共享一个较小的潜在向量;第二是 sequence 维度,例如 DeepSeek-V4 中的 CSA 和 HCA,将每 $m$ 个 token 压缩为一个 entry;第三是 layer 维度,即部分层不再维护自己的 Cache 和选择结果,而是复用其他层的 Cache 及其选择结果,或者直接由更加高效的层替代。
CSA2 联合利用了这三个维度:它在不同层之间共享 main KV 和 indexer K,并允许不同层复用 Top-K indices,实现了 Cache 共享与 index 复用的解耦。在这些复用策略的基础上,CSA2 还使用了一个简化的 compressor,以及一个 Hierarchical Sparse Indexer,后者会在 Decoder 中缩小后续 indexing layer 的搜索范围。
与 CSA 类似,CSA2 包含一个轻量级 indexer。该 indexer 使用 indexer Q 和 indexer K 对 main KV entries 进行打分,并为每个 query 选择 Top-K entries。每个 Q 会同时关注选中的 entries 以及当前层自身的滑动窗口 KV(SWA KV)。CSA2 还将不压缩 main KV 的情况作为一个特例,此时压缩比为 1。与此同时,CSA2 对 compressor 和 indexer 都进行了简化。在 CSA 中,当压缩比为 $m$ 时,每个 main KV entry 由原始 KV Cache 中的 $2m$ 个 entries 生成,并且相邻压缩 entry 所对应的源 entries 之间存在重叠。CSA 还会加入绝对位置编码,用于在压缩过程中编码这 $2m$ 个 entries 的位置。CSA2 移除了这种重叠以及绝对位置编码。此外,CSA2 通过对 main KV entries 进行投影来得到 indexer K,取代了 CSA 中从 hidden states 出发,单独进行压缩的路径。这两项设计都简化了实现,并提高了训练效率。
1. Cross-Layer KV 和 Index Reuse
每个 CSA2 层都会被静态分配为三种模式之一:Full、Reindex 或 Reuse。在这三种模式下,每一层都会计算自己的 query 和 SWA KV,并将它们与选中的 main KV entries 一同用于生成新的 attention output。三种模式的区别在于它们如何获得 main KV、indexer K 和 Top-K indices。下图展示了这三种模式,三种模式的区别在于它们获取 main KV、indexer K 和 Top-K indices 的方式。绿色方块表示在当前层中计算得到的量;黄色方块表示从最近一个 Full Mode 层复用的 main KV 和 indexer K;红色方块表示从最近一个产生 index 的层(Full Mode 或 Reindex Mode)复用的 Top-K indices。三种模式都会在当前层计算自己的 main Q 和 SWA KV。

Full Mode
该层计算自身的 main KV 和 indexer Q,再由该 main KV 投影得到 indexer K,随后运行 indexer,生成新的 Top-K indices。因此,Full Mode 会执行完整的 CSA2 计算路径,其各组件所承担的功能与 DeepSeek-V4 中一个完整的 CSA layer 相同。
Reindex Mode
该层复用前面某一层最近一次可用的 main KV,以及与其对应的 indexer K。indexer 会计算当前层自身的 indexer Q,对复用的 keys 重新打分,并生成新的 Top-K indices。这样,在 main KV 和 indexer K 保持共享的同时,不同层之间的稀疏选择结果仍然可以发生变化。
Reuse Mode
该层复用最近一次可用的 main KV,以及前面某个 Full Mode 或 Reindex Mode 层针对该 main KV 计算得到的最新 Top-K indices。该层直接使用这一选择结果进行 attention,不再计算 indexer Q,也不再计算 index score。
共享 main KV 和 indexer K 可以降低 Cache 存储开销,而复用 Top-K indices 则可以避免额外的 indexer 计算。Reindex Mode 在继续共享 Cache 的同时,允许不同层选择不同的 entries。当 CSA2 与 CED 结合使用时,被分配为 Full Mode 的 decoder layer 会直接从第 $L/2$ 层的 hidden state,也就是 causal encoder 最后一层的 hidden state,计算自身的 global KV。Reindex Mode 和 Reuse Mode 则保持不变。
2. Hierarchical Sparse Indexer
跨层 Reindex 可以减少 indexer 的执行次数,但其余的 indexer 仍然需要对当前 query 在因果关系上可见的完整上下文进行打分。对于超长上下文而言,这一计算成本仍然是一个主要瓶颈。已有工作通过先对池化后的 block representation 进行打分和剪枝,再执行 token-level indexing,从而为 indexer 引入稀疏性。而本文发现,在 decoder 中,可以自然地利用较浅层 indexer 的信息来限制较深层 indexer 所考虑的候选范围,而且不需要引入任何额外状态。因此,提出 Hierarchical Sparse Indexer。它仅用于 CED 的 decoder(因为 encoder 没有 Reindex Mode,而 decoder 有大量 Reindex Mode),以减少 decode 过程中这种重复的打分计算。
对于每个 query,decoder 中的第一层,也是唯一的 Full Mode 层首先对完整的因果可见上下文进行打分,并据此构建一个共享的候选池(candidate pool),后续所有 Reindex Mode 层都仅在该候选池内重新打分并选择各自的 Top-K。当候选池大小固定时,较深层 indexer 对每个 query 的计算成本就会从随上下文长度线性增长,变为常数开销。这一机制是 training-aware 的,并在 post-training 阶段引入:训练和推理过程中使用完全相同的候选范围,因此较深层的 indexer 是在与推理阶段所使用的搜索范围一致的情况下进行优化的。下图展示了这一过程。
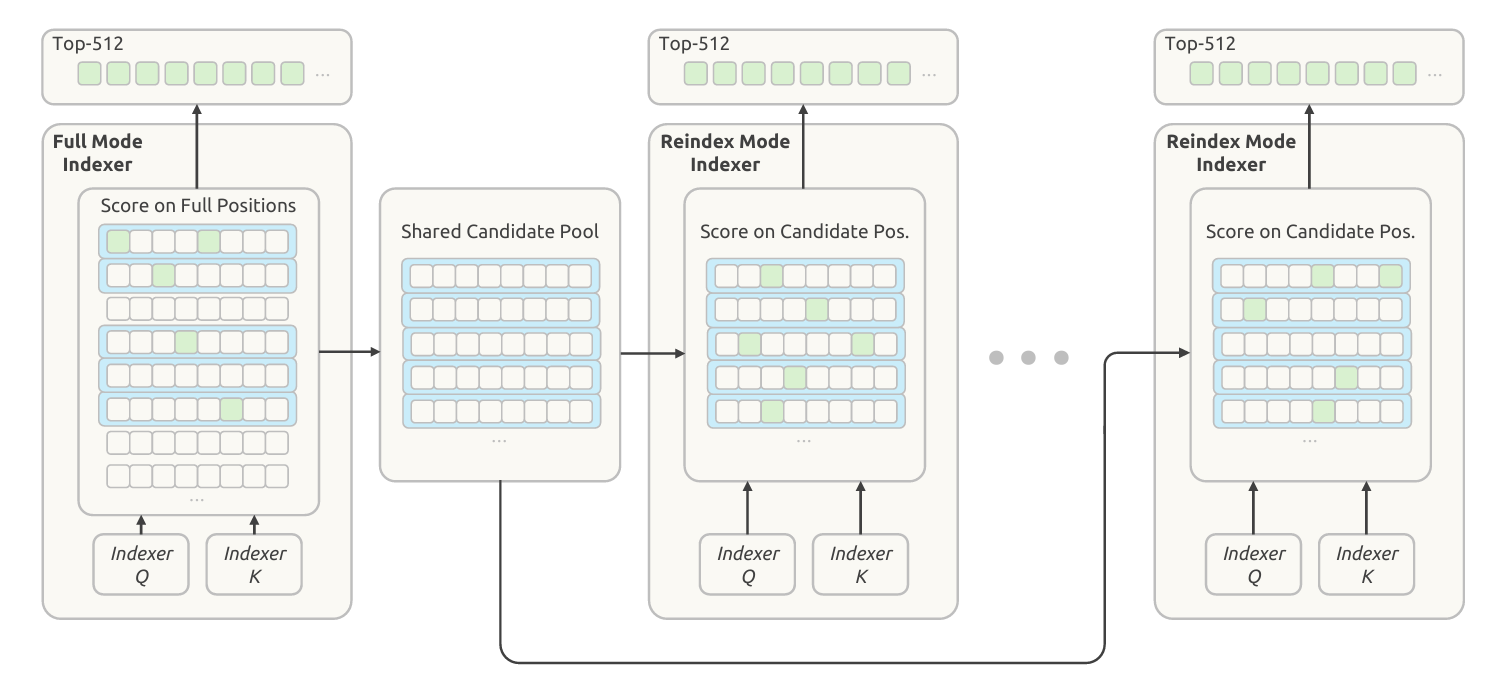
第一个 Full Mode 层会对所有在因果关系上可见的 main KV positions 进行打分,并为自身的 attention 生成 Top-K indices。同时,它还会执行基于 block 的候选选择(blockwise candidate selection):每个 block 的分数取该 block 内所有位置 index score 的最大值,然后选择分数最高的若干 blocks。接下来,将这些被选中 blocks 所覆盖的位置收集起来,形成一个比最终 Top-K 集合更大的 candidate pool。例如,如果选择 2048 个 block,每个 block 包含 8 个 position,那么会得到 16384 个 candidate positions。这个 candidate pool 决定了后续 indexer 的搜索范围,而最终的 Top-K selection 则决定每一层实际读取哪些 main KV entries。
后续处于 Reindex Mode 的层只会针对对应 query 的 candidate positions 进行打分,并在该 candidate pool 内选择自身的 Top-K entries。处于 Reuse Mode 的层不会执行新的 indexing,而是直接使用针对其所复用 main KV 已经计算得到的最新 Top-K indices。因此,不同 indexing layers 会共享同一个 candidate pool,但它们最终选择出的 entries 可以彼此不同。
当 candidate-pool size 固定时,每个后续 indexer 针对单个 query 所需要打分的位置数量都有一个与上下文长度无关的固定上界。不过,第一个 Full Mode 层仍然需要扫描完整的、在因果关系上可见的范围。因此,hierarchical indexing 在保留第一次全范围扫描的同时,降低了后续 indexer evaluation 的计算成本。
(五)高效架构扩展
1. Single-Pass mHC
DeepSeek-V4 引入了 mHC,它会在相邻 Transformer block 之间维护 $n$ 条 residual stream。对于每个 token,将这些 residual stream 记作 $X_l\in\mathbb{R}^{n\times d}$,其中 $l$ 表示 Transformer block 的索引,$d$ 表示 hidden dimension。residual stream 按如下方式更新: \(\begin{equation} X_{l+1} = B_lX_l + C_lF_l(A_lX_l) \qquad (A_l,B_l,C_l)=\mathcal{H}(X_l) \end{equation}\) 其中,$A_l\in\mathbb{R}^{1\times n}, C_l\in\mathbb{R}^{n\times1}, B_l\in\mathbb{R}^{n\times n}$ 是根据 $X_l$ 预测得到的、逐 token 的系数。系数预测器 $\mathcal{H}$ 包含 normalization 和 projection。定义 $\hat{X}_l=A_lX_l$ 是当前 block 真正接收的输入,即一条 $d$ 维向量。定义 $Y_{l-1}=F_{l-1}(\hat{X}_{l-1})$ 是前一个 block 的输出,同样是一条 $d$ 维向量。
站在第 $l$ 个 block 的入口来看,当前手里已经有两样东西:$X_{l-1}\in\mathbb{R}^{n\times d}$ 以及前一个 block 刚算出来的 $Y_{l-1}\in\mathbb{R}^{d}$。接下来想得到两个结果 $X_l\in\mathbb{R}^{n\times d}$,即更新后的 $n$ 条 residual stream,以及 $\hat X_l\in\mathbb{R}^{d}$,即真正送进第 $l$ 个 Transformer block 的 $d$ 维输入。从系统实现角度,最理想的是有一个 kernel,能够实现 $(X_{l-1},Y_{l-1}) \longrightarrow (X_l,\hat X_l)$ 的映射,即一次读进来,一次把最终结果写出去。这样的映射需要读取 $(n+1)d$ 个值,并写入 $(n+1)d$ 个值,因此激活访存流量的理论下界为 $(2n+2)d$。
实际中,DeepSeek-V4 采用 multi-pass 实现。由于数据依赖关系,需要依次执行三个 kernel: \(\begin{align} &X_l = B_{l-1}X_{l-1} + C_{l-1}Y_{l-1} \qquad &\text{Residual update}\\ &(A_l,B_l,C_l) = \mathcal{H}(X_l) \qquad &\text{Coefficients prediction}\\ &\hat{X}_l = A_l X_l \qquad &\text{Input mixing} \end{align}\) 这三个 kernel 分别读取 $(n+1)d$、$nd$ 和 $nd$ 个值,并总共写入 $(n+1)d$ 个值。若再计入 $F_l$ 中的 pre-norm,也需分别读入和写入 $d$,因此总激活访存流量为 $(4n+4)d$,即理论下界的两倍。
前面提到,在 $\mathcal{H}$ 中包含了 normalization 和 projection,实际优化中,normalization weight 会合并到 projection weight 中,而 RMS division 则在 projection 之后执行。假设 RMSNorm 为: \(\begin{equation} \operatorname{RMSNorm}(X_l) = \frac{X_l}{\operatorname{RMS}(X_l)} \odot g \end{equation}\) 后面马上接 projection $W$,那么 scale $g$ 可以提前吸收到 $W$ 中: \(\begin{equation} W' = W\operatorname{diag}(g) \end{equation}\) 于是不用显式生成一个 normalized $X_l$ 再投影。而 RMS 的除法,可以先累积 $X_l W’$ 以及 $\sum_j X_{l,j}^2$,等所有 hidden tile 都处理完、得到 RMS 后,再对 projection output 除以 RMS。这样一来,就可以把 Residual update 和 Coefficient prediction 融合起来,共享一次对 residual 的遍历。Residual update 是: \(\begin{equation} X_l = B_{l-1}X_{l-1} + C_{l-1}Y_{l-1} \end{equation}\) 这里对于 hidden dimension $d$,每一个 tile 可以独立算: \(\begin{equation} X_l^{(t)} = B_{l-1}X_{l-1}^{(t)} + C_{l-1}Y_{l-1}^{(t)} \end{equation}\) 它不需要先看到整个 hidden dimension。因此刚算出一个 $X_l$ tile,就可以立刻: \(X_l^{(t)} \rightarrow \begin{cases} \text{累积 }\mathcal H\text{ 的 projection output}\\ \text{累积 }\sum (X_l^{(t)})^2 \end{cases}\) 也就是一次遍历同时完成 Residual Update + Coefficient Prediction 的大部分计算。不需要先 $X_l$ 写 HBM,然后另一个 kernel 再读 $X_l\rightarrow\mathcal H(X_l)$。然而,Input mixing 无法融合进这一次遍历,因为只有在所有 hidden tile 上的 reduction 完成之后,才能得到 RMS 并进一步得到 $A_l$。因此,需要再次读取 $X_l$,此外,这第二次遍历还可以同时完成 input pre-norm。这样的 two-pass 实现总共需要 $(3n+2)d$ 次 activation 读写,即首先第一次读入 $(n+1)d$ 并写入 $nd$,第二次读入 $nd$ 并写入 $d$,相比理论下界多了一次对 $X_l$ 的读取。
因此,本文引入 Single-Pass mHC,将 input-mixing coefficient 向后移动一个 block。也就是说,每个 block 使用由前一个 block 生成的 mixing coefficient,从而消除上述依赖关系: \(\begin{equation} X_{l+1} = B_lX_l + C_lF_l(A_{l-1}X_l) \qquad (A_l,B_l,C_l)=\mathcal{H}(X_l) \end{equation}\) 此时,input mixing 使用 $A_{l-1}$ 而非 $A_l$,因此它不再依赖由 $X_l$ 计算得到的系数。这样,每个 $X_l$ 的 tile 都可以立即同时用于 input mixing 和 coefficient prediction,而无需等待完整 reduction 完成。假设沿 hidden dimension 分 tile: \(\begin{equation} X_l= [ X_l^{(1)}, X_l^{(2)}, \ldots, X_l^{(T)} ] \end{equation}\) 现在处理第 $t$ 个 tile。第一步,根据上一层状态生成: \(\begin{equation} X_l^{(t)} = B_{l-1}X_{l-1}^{(t)} + C_{l-1}Y_{l-1}^{(t)} \end{equation}\) 也就是 residual update。此时因为 $A_{l-1}$ 已经存在,可以立即计算: \(\begin{equation} A_{l-1}X_l^{(t)} \end{equation}\) 由此累积形成 $\hat X_l=A_{l-1}X_l$,这就是 input mixing。与此同时,同一个 $X_l^{(t)}$ 还可以拿来累计 $\mathcal H(X_l)$ 所需要的 projection 和 RMS statistics,以便最终产生 $(A_l,B_l,C_l)$,也就是 coefficient prediction。所以一个 tile 一到手,同时干了三件事: \(\begin{equation} X_l^{(t)} \rightarrow \begin{cases} \text{Residual update}\\ \text{Input mixing using }A_{l-1}\\ \text{Coefficient prediction for }A_l,B_l,C_l \end{cases} \end{equation}\) 根据经验,这种转换带来的性能下降可以忽略不计。在预训练阶段,只修改为了 Single-Pass 的形式,但仍然保留现有的 multi-kernel 实现。
这可能是因为:通过修改,已经从公式上取消了对 $A_l$ 的依赖,但训练除了 forward,还会涉及到 backward,继续用现有 multi-kernel 实现复杂度、代价会小很多。此外训练是计算密集的,花大量工程成本实现训练版 fused forward/backward kernel,收益未必足够大。相比之下,推理则会更在意这种 HBM traffic。
在部署阶段,则将 residual update、input mixing 和 coefficient prediction 融合进一个单独的 kernel,称为 Mega-mHC。该 kernel 在实现 mHC 时需要 $(3n+2)d$ 次 activation 读写,而实现 Single-Pass mHC 时仅需要 $(2n+2)d$ 次 activation 读写。Mega-mHC 沿 hidden dimension 将 $X_l$ 划分成多个 tile 进行处理。每个 tile 既用于计算 mixed input,也用于累积预测下一个 block 的 $(A_l,B_l,C_l)$ 所需的量。该 kernel 同时融合了 input pre-norm 和 FP8 conversion。由此,residual 只需要读取一次并写入一次,从而达到理想映射所要求的 $(n+1)d$ 次读取和 $(n+1)d$ 次写入,并将原始实现中的激活访存流量减半。
2. Engram
DeepSeek-V4.1-Flash 中加入了 Engram,这是此前工作中提出的一种 conditional memory module,用于将记忆与计算解耦。本文沿用了原始 Engram 的设计,包括 tokenizer compression、multi-head hashing、context-aware gating 和 multi-branch integration,同时进行了两项修改。首先,移除了 short causal convolution,因为它带来的性能提升不足以抵消其在推理栈中引入的额外复杂度。其次,使用基于动量的更新,并在其后执行 Sinkhorn balancing,来优化 Engram embedding。
DeepSeek-V4.1-Flash 将 196B Engram 参数平均分配到两个 module 中。每个 module 使用 $N$-gram orders {2,3,4},包含 8 个 hash head,每一种 $N$-gram order 总 embedding dimension 均为 2048。每个哈希头索引一个约包含 16M entries 的 table,不同 table 的大小被设置为不同的质数。Embedding table 和 key/value projection 均采用 FP8 精度。这两个 module 被放置在第 1 层和第 14 层(索引从 0 开始),以平衡不同 training pipeline stage 之间的内存占用。在推理过程中,由于地址是确定性的,可以通过后台 RDMA 传输,从 host memory 中预取 embedding。对于第一个 Engram module,其预取过程可以与第一个 Transformer block 的计算重叠执行。
3. DSpark
DeepSeek-V4.1-Flash 配备了 DSpark,这是一个结合了半自回归 draft 生成与置信度调度验证的投机解码模块。Drafter 由三个 Transformer block 组成,采用 128 个 token 的滑动窗口注意力。这三个 block 经过一次 forward pass,可以并行计算 5 个 draft position 的 base logits。与此同时,一个轻量级的 Markov head 用于建模这些 draft token 之间的依赖关系。置信度头会预测每个 position 的条件接受概率,并利用它们估计前缀存活概率。Scheduler 将这些估计值与预先分析得到的引擎吞吐曲线结合起来,为每个 request 动态选择 verification length,旨在在当前系统负载下最大化预期系统吞吐。
与 DeepSeek-V3 中的 MTP module 不同,MTP 在整个预训练过程中与 backbone 联合训练,而 DSpark 则在预训练完成之后的一个独立阶段中引入。在这一阶段,冻结 backbone,只训练 DSpark。在 post-training 阶段,继续让 DSpark 与 backbone 一同训练,且不将 DSpark 目标的梯度回传到 backbone 中,即梯度目标彼此解耦。这样可以使 DSpark 始终与不断演化的 policy 保持一致,从而同时加速在线 serving,以及 RL 和 OPD 中的 rollout generation。
4. FP4 Main KV Cache
长上下文 Agent 工作负载需要为每个 request 维护大规模 KV Cache,从而增加 serving 成本。DeepSeek-V4 已经对 FP4 的 indexer query 和 key 使用 quantization-aware training(QAT),以加速索引计算并减小 indexer cache 的大小。尽管在实验中,其他格式可以获得更高的精度,但仍然采用符合 OCP 标准的 MXFP4 格式,以支持尽可能多的硬件平台。
现在,进一步将 QAT 扩展到 main KV Cache。在这里,FP4 的作用是降低存储开销,而不是加速矩阵乘法。由于可以在执行 attention 之前先对缓存值进行反量化,因此可以使用精度更高的格式,而无需硬件原生支持该格式的矩阵乘法,同时仍然保持跨硬件平台的兼容性。在评估的多种 4-bit 格式中,最终选择了 E2M1,并为每 16 个 channel 配置一个 E4M3 scale。这一设计参考 NVFP4,但为了在精度与简洁性之间取得平衡,移除了其中的第二级 global scale。移除这一 scale 后,main KV Cache 仍然具有充足的动态范围:该格式能够表示的幅值最高达到 $448\times6=2688$,远高于 Cache 本身的幅值上界。在 DeepSeek-V4.1-Flash 中,训练得到的 RMSNorm weight 的最大幅值约为 1。经过 RMS normalization 之后,512-channel KV latent 的 $L_2$ norm 最大约为 $\sqrt{512}$,RoPE 会保持这一 norm 不变,因此旋转之后各 channel 中最大绝对值的上界同样约为 $\sqrt{512}\approx22.6$。此外,训练过程中实际观察到的最大幅值约为 10。因此,移除 global scale 并不会造成可测量的精度下降,同时还能够简化 Cache layout。
为了在 DeepSeek-V4.1-Flash 中实现 FP4 main KV Cache 存储,我们在 post-training 阶段引入 QAT。non-RoPE component 与 RoPE component 使用相同的量化格式。我们选择在 RoPE 之后对 Cache 进行量化:在实验中,于 RoPE 之前进行量化只能带来很小的精度提升,同时还会在 decode 阶段引入额外开销。由于 SWA KV Cache 对量化更加敏感,仍然为其保留 FP8 精度。与 DeepSeek-V4 中的 FP8 main KV Cache 相比,该 FP4 格式能够将存储占用降低近一半,无论 Cache 驻留在 HBM 中,还是被 offload 到 SSD 上,都是如此。
(六)优化
在 DeepSeek-V4 所采用的优化配置基础上,进行了一些新的调整,以更好地适配当前的架构设计。
首先,采用 head-wise Muon,在应用 Muon 更新之前,先按 attention head 对 Query 权重进行拆分。如果将 Muon 看作一种预条件梯度下降(preconditioned gradient descent)方法,那么标准 Muon 会对所有 head 使用同一个 preconditioner,而 head-wise Muon 则会为不同 head 提供不同的 preconditioner。这样的设计能够更好地处理不同 attention head 之间的异质性。实验中可以观察到 head-wise Muon 的性能优于标准 Muon。head-wise Muon 的经验优势也在 GLM 5 和 Kimi-K3 中得到了验证。
其次,对新引入的 Engram 参数使用 Adam,会显著增加 optimizer state 的内存占用。为了降低训练期间的内存使用,改为使用一种基于动量的更新,并在其后进行 Sinkhorn balancing,来优化 Engram embedding table、token embedding 和 prediction head。与 Muon 类似,这种方法只需要维护一个 momentum buffer,同时在实验中取得了优于 Adam 的表现。
1. 基础配置
对于 normalization layer 的权重,以及 bias 和 scaling factor 等其他非矩阵参数,仍然采用 AdamW。对于语言模型 backbone 中线性变换的权重矩阵、Engram projection layer,以及 vision-language projector,使用 Muon。其中,对于 Query 和 Key 权重,使用 head-wise Muon。
在 Muon 中采用 decoupled weight decay 和 Nesterov momentum(即向前看一步);normalization layer 的权重同样应用 weight decay,而 bias 和 scaling factor 则不使用 weight decay。采用 Sinkhorn balancing 的更新同样使用 Nesterov momentum,但不应用 weight decay。
在预训练期间,将 vision encoder 保持冻结,直到进入学习率衰减阶段;与此同时,其最后一个 normalization layer 以及 vision-language projector 始终保持可训练。在学习率衰减开始时,解冻 vision encoder,并使用较小的学习率将其与 LLM 一同进行联合优化。
2. Sinkhorn-Balanced Update
Sinkhorn balancing 用于 Engram embedding、token embedding 和 prediction head 这些大矩阵参数,完整过程总结在算法 1 中。从整体上看,它与 Muon 遵循相同的工作流程,只是用 Sinkhorn balancing 替代了 Newton–Schulz orthogonalization。
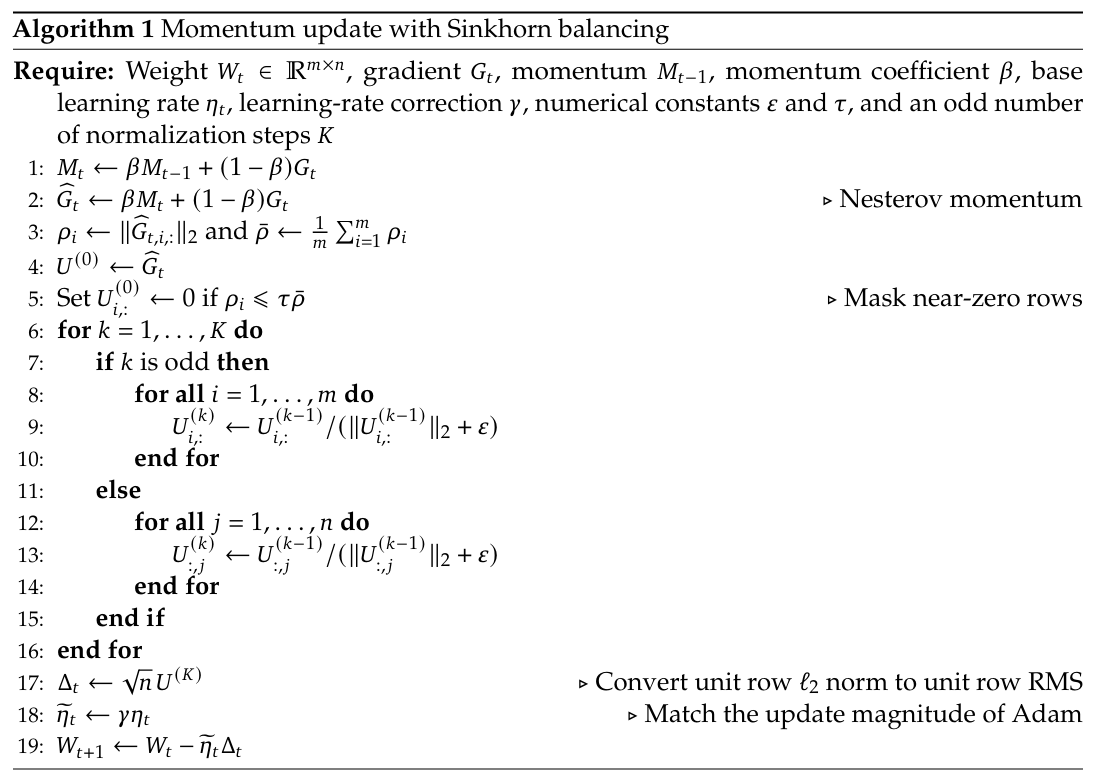
我们将矩阵中较大的维度记为 $m$。对于 embedding table 和 prediction head,该维度对应 vocabulary size;hidden dimension 则记为 $n$。给定经过 Nesterov momentum 得到的更新矩阵 $\hat G_t\in\mathbb R^{m\times n}$,Sinkhorn balancing 会寻找两个对角缩放矩阵 $D_r$ 和 $D_c$,使得: \(\begin{equation} \Delta_t = \sqrt{n}\,U^{(K)} = \sqrt{n}\,D_r\hat G_tD_c \end{equation}\) 并满足: \(\begin{equation} \frac{1}{n} \sum_{j=1}^{n} (\Delta_t)_{ij}^{2} \approx 1, \qquad \frac{1}{m} \sum_{i=1}^{m} (\Delta_t)_{ij}^{2} \approx 1 \end{equation}\) 因此,这一过程会近似地将更新矩阵的逐行 RMS 和逐列 RMS 都调整到相同尺度。这里,一行对应一个 token index 或 $N$-gram identity,而一列对应一个 hidden feature。Sinkhorn balancing 利用这种 token–feature 结构,同时沿行方向和列方向进行归一化。
在实现上并不是求两个复杂矩阵,而是在反复做行缩放、列缩放,Sinkhorn balancing 的核心操作非常简单:行归一化 $\rightarrow$ 列归一化 $\rightarrow$ 行归一化 $\rightarrow \cdots$ 反复若干次。第一步把每一行除以自己的 $\ell_2$ norm,下一步再把每一列除以自己的 $\ell_2$ norm,然后继续交替,最终得到更新矩阵 $\Delta_t$,这和 mHC 中的 mixing matrix 迭代很像。假设一个向量是 $x=(x_1,\dots,x_n)$,如果除以它的元素和: \(\begin{equation} x'=\frac{x}{\sum_i x_i} \end{equation}\) 那么立刻有: \(\begin{equation} \sum_i x'_i=1 \end{equation}\) 如果除以它的 $\ell_2$ norm: \(\begin{equation} x'=\frac{x}{\|x\|_2} \end{equation}\) 那么立刻有: \(\begin{equation} \|x'\|_2 = \sqrt{\sum_i (x'_i)^2} =1 \end{equation}\) 对矩阵来说通过行列反复迭代,让两个约束逐渐同时接近满足。这里让行列的 $\ell_2$ 尺度达到平衡,最后还乘了 $\sqrt n$,因此最终表达的是: \(\begin{equation} \text{row RMS}\approx1, \qquad \text{column RMS}\approx1 \end{equation}\) 即因子 $\sqrt n$ 用于将单位行 $\ell_2$ norm 转换为单位行 RMS。此外,这里有一个很细的点:算法里 $K$ 取奇数,因此最后一步是 row normalization。所以最后时刻行 $\ell_2$ norm 最接近严格的 1(忽略 $\varepsilon$ 和被 mask 的行),而列是经过前面反复迭代后近似达到目标。说明行 RMS 是想要优先保证的,因为一行本身就是一个完整的语义参数单元。例如 token embedding 中 $W_{i,:}$ 就是第 $i$ 个 token 的整个 embedding vector。这一整行控制更新尺度,相当于控制每个 token / n-gram embedding vector 在一次 optimizer step 中整体移动多远。
综上,Sinkhorn balancing 这么做的目的是,某些高频 token 可能梯度特别大,某些 token 很少出现。不同 hidden feature 的梯度尺度也可能不同。如果直接更新 $W\leftarrow W-\eta G$。那么不同 token、不同 feature 的更新幅度可能非常不均衡。Sinkhorn balancing 就是在两个维度上同时做平衡,把梯度矩阵先沿行、列反复做归一化,使不同 token 和不同 hidden feature 的更新尺度都更加均衡,再进行参数更新。
为了保证数值稳定性,对于满足: \(\begin{equation} \rho_i\leq\tau\bar{\rho} \end{equation}\) 的行,会将其 mask 掉。其中:
\(\begin{equation} \rho_i=\left\|\hat G_{t,i,:}\right\|_2 \end{equation}\) 表示第 $i$ 行的 $\ell_2$ norm,也就是第 $i$ 个 token / n-gram 对应那一整行 update 的大小。然后: \(\begin{equation} \bar\rho = \frac1m\sum_{i=1}^{m}\rho_i \end{equation}\) 表示所有行 $\ell_2$ norm 的平均值。所以 $\tau\bar\rho$ 就是一个接近零的阈值,其中 $\tau$ 是一个很小的 numerical constant。因此条件 $\rho_i\le\tau\bar\rho$ 的意思就是:如果第 $i$ 行的 update norm,相比所有行的平均 norm 小得过分,那么认为这一行几乎为零。然后就把这一整行 mask 掉,不再参加后续的 Sinkhorn 归一化。因为是假如某一行原来几乎为 0,如果硬把它除以自己极小的 norm,就会把一个本来几乎没有梯度信号的行强行放大到 norm 约等于 1,可能放大数值噪声。另外,为了使更新幅度与 Adam 相匹配,将有效学习率调整为 $\tilde{\eta}_t=\gamma\eta_t$,这里设置 $\gamma=0.18$。
二、通用基础设施
(一)训练基础设施
1. 多模态训练基础设施
对比学习中的通信-计算重叠
Vision encoder 首先使用对比学习进行优化,随后再使用生成式 next-token prediction loss 进行微调。在 contrastive 阶段,loss 是在一个完整 batch 的 text–vision pair 上计算的,因此必须在不同 rank 之间对两种模态的 feature 执行 all-gather,这会带来相当大的通信开销。
由于 text feature 的梯度只依赖于已经聚合后的 visual feature;对称地,visual feature 的梯度也只依赖于已经聚合后的 text feature,因此,每一次 all-gather 都可以与 forward 或 backward 过程重叠,而不必让整个 pipeline 停下来等待通信: \(\begin{equation} \begin{aligned} \operatorname{Forward}(V) \rightarrow \left[ \operatorname{Forward}(T) \parallel \operatorname{AllGather}(V) \right] \rightarrow \nabla \operatorname{Text} \\ \rightarrow \left[ \operatorname{Backward}(T) \parallel \operatorname{AllGather}(T) \right] \rightarrow \nabla \operatorname{Vision} \rightarrow \operatorname{Backward}(V) \end{aligned} \end{equation}\) 其中,$V$ 和 $T$ 分别表示 visual feature 和 text feature;$(A\parallel C)$ 表示计算 $A$ 与通信 $C$ 重叠执行;$\nabla$ 表示梯度计算。在这一调度方式下,visual feature 的 all-gather 会在 text forward 期间完成,而 text feature 的 all-gather 会在 text backward 期间完成,因此两次 all-gather 都可以被有效计算完全掩盖。
端到端并行
为了处理 vision encoder 与 LLM 在模型结构和数据方面的异构性,采用了近期训练系统中使用的 disaggregated encoder 设计。vision encoder 被复制并部署在 LLM parameter tree 之外,每个 training step 被划分为三个阶段:
(1)vision encoder forward;
(2)LLM forward/backward;
(3)vision encoder backward。
这种拆分方式避免了 vision encoder 与 LLM 的计算相互干扰。经过负载均衡的 vision processing 只发生在第一个和最后一个阶段,而中间的 LLM 阶段完全不包含 vision computation,因此可以继续沿用纯文本训练时的并行策略。
长序列多模态训练优化
DeepSeek-V4.1-Flash 的训练序列长度最高达到 1M tokens,并且无论在 pre-training 还是 post-training 阶段,都有相当比例的训练发生在超长序列长度下。在这种序列长度下,如果包含很多图片,它的原始数据量会非常巨大,会带来严重的 I/O、CPU 和内存瓶颈。
(1)Balanced image sharding
在 pre-training 期间,一个包含大量图片的超长序列,在加载过程中就可能耗尽单台 host 的 I/O、CPU 和内存资源。因此,将每个 sequence 中的图片在不同 CP (Context Parallelism) ranks 之间进行负载均衡式切分,并确保每张图片恰好只被加载一次。当每张图片只读取一次时,只要满足: \(\begin{equation} \frac{N\times \rho}{B_{\mathrm{IO} }} < \frac{N\times C}{B_{\mathrm{GPU} }} \end{equation}\) 图片加载的开销就可以被计算完全掩盖。上式的左边可以理解成数据加载时间,右边表示 GPU 计算时间,只要左边小于右边,那么 GPU 在计算上一批数据时,CPU/存储就有足够时间把下一批数据加载好。其中,$N$ 表示 token 数量;$\rho$ 表示平均每个 token 对应的 raw bytes;$C$ 表示每个 token 所需的计算量;$B_{\mathrm{IO} }$ 和 $B_{\mathrm{GPU} }$ 分别表示文件系统带宽和 GPU 带宽。上式可进一步化简为: \(\begin{equation} \rho < \frac{B_{\mathrm{IO} }}{B_{\mathrm{GPU} }}C \end{equation}\) 由于 $N$ 在不等式两边可以约掉,因此该条件只与 per-token 的量有关,即 $\rho$ 和 $C$,而与 sequence length 和 cluster size 无关。其中,$\rho$ 由 vision module 的配置决定,例如 resolution cap 或 spatial downsample。因此,存储吞吐只有在每 token 计算量较低的小模型中才会成为瓶颈,而对于生产规模的模型,仍然主要受计算限制。
(2)Incremental image transfer
除了上述 balanced sharding 之外,在 RL rollout 阶段,只会以增量方式将图片传输到推理引擎。同时,推理引擎在 CPU 端完成的 decoding 和 preprocessing 结果会缓存在 distributed file system 中,从而可以在后续 rollout 以及随后的训练过程中重复利用。
2. CSA2 的 Attention Sharing Training
前面介绍过 CSA2,这是一种包含三种工作模式的 attention sharing 方法,会让多个 layer 共享以下一个或多个内容:main KV、indexer K、Top-K indices。要在大规模分布式训练中支持 CSA2,仅仅实现 attention computation 本身还不够,还需要额外的协调机制。
特别的,共享注意力组件的不同 layer 可能被放置在不同的 pipeline stage 上,因此直接的模块复用与传统的 stage-local execution 并不兼容。所谓 stage-local execution 就是指:一个 stage 内部的计算、模块、参数,只在当前这个 stage 的设备上完成;跨 stage 只传递输出张量,不跨段复用模块 / 参数。为此,采用了以下几种设计来支持 CSA2 的训练。
(1)Shadow indexers
先考虑 indexer,假设某个 indexer 的参数逻辑上应该是共享的,但是使用它的两个 layer 被分到了不同 stage:
\[\begin{equation} \begin{aligned} \text{Stage 0}: \text{Layer A} \\ \text{Stage 1}: \text{Layer B} \end{aligned} \end{equation}\]最直接的想法是:Stage 1 每次需要 indexer 时,去 Stage 0 调用那个 module。但这会非常麻烦,因为 PP 框架默认一个 stage 只执行自己本地的 module。Shadow Indexer 的思路是,不把一个 module 横跨两个 stage 执行,而是在需要它的每个 stage 都放一个轻量的可执行副本。可以理解成:
\[\begin{equation} \begin{aligned} \text{Stage 0}: I_{\text{owner} } \\ \text{Stage 1}: I_{\text{shadow} } \\ \text{Stage 2}: I_{\text{shadow} } \end{aligned} \end{equation}\]这样每个 stage 都可以本地执行 indexer,训练框架看起来仍然是每个 stage 只执行自己的本地 module,所以不用彻底修改 PP scheduler。但这里存在一个新问题:三个副本的参数必须始终一样。因此规定只有一个 logical owner,owner 负责 optimizer update 以及 checkpointing。Shadow replica 只是用于执行计算,训练过程中通过 parameter synchronization 确保参数一致。多个副本在 backward 中产生的梯度,则通过 gradient aggregation 汇总给 owner。这种设计能够维持原始的模型语义,同时不需要 pipeline scheduler 将这些共享 layer 当作特殊的执行单元来处理。
(2)Pipeline payload extensions
Shadow Indexer 主要解决的是 module / parameter 的问题。但 CSA2 还有另一类需要共享的东西:main KV、indexer K、Top-K indices,这些不是静态参数,而是由当前 batch 的 forward 动态生成的中间状态。因此,本文扩展了 pipeline 中传递的 payload,将这些状态加入现有的 point-to-point communication path 中。
此外这些状态可能非常大,模型又在做 Context Parallelism(CP),那么共享的 main KV 等状态也应该按照同样的 sequence partition 来切分。不能因为要跨 PP stage 共享,就突然让每个 CP rank 都拿一份完整 KV,否则长上下文下内存和通信成本会非常夸张。因此这些状态还会按照 context parallelism 的方式进行一致的 partition,从而避免不必要的数据复制,同时还必须保留 gradient flow,因为这些共享状态仍属于计算图的一部分。
(3)Micro-batch-level shared-state management
到这里还有一个很麻烦的问题:Pipeline Parallelism 同时有很多 micro-batch 在流水线里。例如典型 PP: \(\begin{equation} \begin{aligned} MB_1, MB_2, MB_3, MB_4 \end{aligned} \end{equation}\) 同时处于不同 stage。那么 Full Layer 产生的 shared state 也不是只有一份,每个 micro-batch 都必须使用自己的 main KV、indexer K、Top-K。因此系统会在 micro-batch 粒度上跟踪当前并发活跃的 pipeline micro-batch 所对应的 shared state,并协调这些状态在 forward、activation recomputation、backward 过程中的生命周期。Shared state 会一直保留到它最后一个 consumer 完成使用,之后便立即释放,从而限制额外的内存开销。
同一套运行时抽象还会负责处理 stage placement 以及 source–consumer relationship,使注意力机制的实现能够直接访问 shared state,而无需依赖实际的物理流水线布局。结合对 optimizer、checkpointing、warm-up 和 computation-graph tracing workflow 所做的一些轻量级适配,上述机制使 CSA2 可以在已有的 distributed training interface 和 pipeline schedule 下透明地运行。
3. Engram
Engram embedding table 会按照行进行切分,并分布到具有 engram parallel size 大小的专用进程组中。Group size 控制了单设备内存占用和 embedding 查找通信范围之间的权衡。对于每一个 table partition,其 optimizer state 还会进一步在对应 replica 之间进行 sharding。
Engram 的 lookup index 只由输入 token sequence 决定。因此,在当前 training step 中,每个 pipeline stage 开始处理 micro-batch 之前,就可以提前针对整个 local batch 发起 embedding prefetch,从而尽量减少其对 pipeline execution 的干扰。在 backward 过程中,embedding gradient 会先被缓存在本地,等 backbone backward 完成之后,再将这些 gradient 返回给其对应的所属 rank。为了高效地与 multimodal training 集成,embedding prefetch 和 gradient transfer 还会被安排为分别与 vision encoder 的 forward 和 backward computation 重叠执行。
Engram embedding 采用 FP8 进行存储和读取。取回后的 embedding value 以及对应的 scaling factor 会被直接传入后续 GEMM。对于 Engram table 的更新,Sinkhorn normalization 每一次迭代会持续维护 row scaling vector 和 column scaling vector,从而避免反复写入完整的 normalized matrix。同时,row normalization 与 partial column statistics 的累积会被融合进同一个 kernel,以进一步降低 memory traffic。在 RL rollout 阶段,Engram embedding table 会始终驻留在 GPU memory 中。这样的部署方式可以减轻主存压力,并有助于避免由于主存碎片导致的 OOM。
(二)推理系统
DeepSeek V4.1 Flash 从设计之初就将推理效率作为首要考虑因素。尽管其架构在概念上较为复杂,但最终的推理内核执行流程却非常简洁。通过合理的内核融合,将复杂操作封装起来,并在少量融合内核中让硬件资源保持充分的流水化执行。这些内核包括 FlashMLA 中的融合 RoPE-Attention-RoPE-Cast 内核,DeepGEMM 中的 Mega-Gate、Mega-mHC 和 Mega-MoE 内核,TileKernels 中的相关内核,以及 DeepSelect 中的 TopK 内核。因此,对于绝大多数 Transformer 层,也就是 CSA2 工作在 Reuse Mode 的那些层,在 prefill 阶段只需要执行 15 个内核,在 decode 阶段只需要执行 11 个内核,从而同时实现高吞吐和低延迟推理。在部署层面,采用 Encoder–Prefill–Decode(EPD)分离架构,使视觉编码、prefill 和 decode 可以分别独立扩展,并且能够相互重叠执行。
1. 持久化 KV 缓存管理
在相同工作负载下,V4.1 将持久化 KV 缓存的占用降低到了 V4 的 1/8。这一降低来自两个因素:第一,持久化 KV 缓存不再保存 SWA KV,因此容量几乎减半;第二,通过架构和数值精度方面的优化,其中保留的 global KV 又进一步压缩到了 V4 占用的 1/4。
在 V4 的部署方案中,SWA KV 几乎占据了持久化 KV 缓存容量的一半。其中,global KV 和 SWA KV 独立管理,并采用 LRU 淘汰策略。Global KV 会被完整保存;一旦缓存命中,就可以直接复用完整的前缀。SWA KV 的处理方式不同。它只会在两个特定位置保存:prompt 结束位置和 output 结束位置。这样可以支持重新生成以及多轮会话。一旦命中 SWA KV,就可以从该缓存位置继续进行计算。为了维持较高的缓存命中率,V4 在 SSD 上配置了足够大的持久化 KV 缓存。在典型工作负载下,两类 KV 都能够保存超过 72 小时。尽管 SWA KV 在指定缓存位置只需要保留 $n_{\text{win} }$ 个 KV 条目,但由于这些 KV 没有经过压缩,它们依然会带来相当大的存储开销,尤其是在每轮对话都比较短的多轮会话中。
长期保存 SWA KV 的成本很高,同时效率也不高,因为它的访问模式并不适合持久化 KV 缓存所采用的长时间保留策略。Global KV 往往具有较长尾的复用特征;相比之下,SWA KV 通常只会在一个活跃会话内部、分钟级的短时间窗口中被复用。一旦会话结束,或者进入下一轮交互,之前的 SWA KV 就会失去作用。V4 技术报告曾提出 Zero SWA Caching,即不再存储 SWA KV,而是在需要时重新计算缺失的 SWA KV,从而省去存储开销。但如果要精确恢复 SWA KV,需要对 $L\times n_{\text{win} }$ 个 token 执行完整前向计算。实际生产部署表明,这一代价过高。因此,V4.1 对持久化 KV 缓存管理做了如下修改:
第一,SWA KV 不再保存到持久化 KV 缓存中,而是存放到一个分布式内存池里。每台机器会拿出约 10% 的主机 DRAM 用于这个内存池。尽管这个内存池的总容量远小于持久化 KV 缓存,但它的生存时间很短,仅为几分钟。因此,一旦某个条目过期,其占用空间就可以立即回收,并用于新的会话。真实工作负载下,这种高速周转已经足以服务绝大多数同时活跃的会话。Global KV 则仍然保存在持久化 KV 缓存中,并保证至少 72 小时 的存活时间。
第二,SWA KV 被淘汰后不可避免地会产生缓存未命中。对此,V4.1 引入了一个轻量级回退方案,即 Encoder SWA Bounded Replay,具体在下一小节介绍。对于那些虽然命中了 global KV、但没有命中 SWA KV 的少量请求,只需要重新计算最近的 $n_{\text{win} }$ 个 token,就能够恢复所需状态,而不再需要对 $L\times n_{\text{win} }$ 个 token 执行完整前向计算。这种有限回放机制是整个方案的关键:它将原本代价极高的缓存未命中,变成了一个开销较小、可以平稳处理的退化情况,从而使“不再把 SWA KV 存入持久化缓存”这一设计成为可能。
2. SWA 有限回放
由于 SWA 的依赖关系会随着层数不断累积,如果要精确重建 $L$ 层的 SWA KV,就需要回放 $L\times n_{\text{win} }$ 个 token。SWA Bounded Replay 只回放最近的 $n_{\text{win} }$ 个 token,并将 SWA 的注意范围截断在这段回放区间内,因此接受一个近似状态。假设回放从位置 $s$ 开始,那么位置 $i$ 的 query 只会关注 $[\max(s,\ i-W+1),\ i]$ 范围内的 SWA key。
(1)Encoder SWA Bounded Replay
编码器侧的 SWA 有限回放,使得前缀缓存只依赖 global KV,因此 SWA KV 可以完全从持久化 KV 缓存中移除。当编码器的 SWA KV 缺失时,我们会取缓存前缀中最后的 $n_{\text{win} }$ 个 token 进行回放,并将它们和没有命中缓存的后缀一起处理。对于这些被回放的 token,只重新生成 SWA KV;已经缓存的 global KV 会直接复用,不会重新计算,也不会被覆盖。而对于没有命中缓存的后缀,则同时生成 global KV 和 SWA KV。由于这种设计本身采用了近似回放,因此被回放的前缀状态并不是精确状态。这也意味着,对于没有命中缓存的后缀,其最终得到的 global KV 和 SWA KV 会依赖于缓存命中的位置;如果命中位置不同,这些状态在数学上也不会完全一致。不过实验结果表明,这种有限回放策略对最终回答质量的影响非常小。
(2)Decoder SWA Bounded Replay
解码器侧的 SWA 有限回放,将解码器的前向计算限制在最近的 $n_{\text{win} }$ 个 token 上,因此可以使整体 prefill 计算量接近减半。在 CED 架构下,解码器的 global KV 是由编码器最终输出的隐藏状态投影得到的。因此,从理论上说,prefill 在编码器结束之后就已经可以停止。唯一的障碍是 decoder SWA KV。解码器的 SWA KV 是由每一层解码器自身的隐藏状态生成的,并且在最开始的几个 decode step 中需要使用。由于系统从不缓存 decoder SWA KV,如果要精确恢复它,就必须让最后 $\frac{L}{2}\times n_{\text{win} }$ 个 prompt token 依次经过 $\frac{L}{2}$ 层 decoder。当一个很短的未缓存后缀接在一个很长的已缓存前缀之后时,这种计算代价尤其高。因此,V4.1 在这种情况下同样采用有限回放。在每次 prefill 时,只回放 prompt 最后的 $n_{\text{win} }$ 个 token。先得到这些 token 的编码器输出,然后在相同的 SWA 截断规则下,将这些编码器输出送入 decoder 各层。最终生成的 decoder SWA KV 只用于后续 decode,不会写入前缀缓存。按照这一设计,重建出的 decoder SWA KV 与执行完整 decoder 前向得到的结果在数学上并不完全相同。不过实验表明,这种近似对回答质量的影响同样可以忽略。为了进一步提高稳健性,在 post-training 阶段还会模拟同样的回放过程,使模型能够在训练中适应这种近似状态。
三、预训练
(一)数据构建
文本数据治理
为了追求更高水平的模型智能,不再仅关注小规模实验中体现出的单个样本质量,而更加关注整个语料库中不同数据之间能够带来的独特信息增益。采用更加系统化、标准化的数据构建流程,以提升数据质量并优化数据比例。具体而言,基于更加全面的评测结果,设计了一套覆盖模型规模与训练数据规模的扩展阶梯(scaling ladder),用于指导大规模训练。过滤掉信息增益有限的模型生成内容,包括较弱模型生成的文本以及低质量机器翻译数据。我们将这类数据视为隐式重复(implicit duplication):它们通常只是重复已有信息,长期训练过程中可能会对模型产生负面影响。此外,还探索了模型参与数据迭代(model-in-the-loop)的数据构建方式,为未来大规模合成数据提供基础。同时,引入更多领域专家,构建更加细粒度的数据质量评估标准。相比上一代模型,本次训练语料进一步加入:新发布的开源代码仓库、最新代码提交、新兴软件库、新出现的开发框架。这些数据覆盖更多编程语言,更贴近当前真实的软件工程场景。
多模态数据治理
多模态预训练数据主要包括三类:图像-文本对、图像-文本交错数据、领域专用数据。基于原始互联网数据天然包含大量多模态知识的前提,我们避免了大规模的数据合成,而优先对原始数据进行清洗和利用,以实现更加直接、更容易扩展的视觉知识学习。在早期数据采集中,我们发现传统爬取系统过于偏向文本内容。因此,基于 Common Crawl 重新构建了数据采集系统,以提升多模态数据来源的覆盖范围。
对于图像-文本对数据:从网页中提取图像以及对应的替代文本(alt text)。随后进行图文相关性过滤、基于图像语义的去重。
对于图像-文本交错数据:其主要来源包括网页、PDF 文档。由于大规模多模态数据处理相比纯文本需要更高的 CPU 和磁盘成本,我们采用多阶段、逐步增加成本的数据处理流程。具体包括:第一阶段:在图像检索之前,进行启发式过滤、统计过滤、数据去重、质量模型筛选。目标是提前去除低价值文档。第二阶段:将保留下来的文档组织成图像-文本交错序列,然后进一步进行图像感知过滤、图像感知去重。第三阶段:使用 SmolVLM 对图像和文本内容进行严格质量评分,从中筛选高质量交错数据。部分被过滤掉的文档,会经过重新筛选和组织,转化为额外的图像-文本对数据。
为了弥补互联网数据自身存在的不足,还加入领域专用数据集,以增强细粒度视觉理解能力、OCR 能力、长尾知识获取能力。此外,收集大量图像-代码数据、计算机使用(computer-use)轨迹。以增强模型对多模态智能体任务的理解能力。
数据融合与去重
文本数据和多模态数据分别经过不同的数据处理流程,最终训练语料取二者的并集:重叠样本用多模态版本替换纯文本版本,并取两种配置中较大的 epoch 数。替换后,语料按纯文本 : 多模态 = 7 : 1 的 token 比例构成。通过联合预取和数据分配策略,尽量减少预训练阶段与上下文扩展阶段之间的数据重复。对于超长文档,在混合数据之前进行确定性的预切分,确保训练 token 在数据分片与训练步上均匀分布训练步骤。此外,进一步改进了最佳适配装箱算法(best-fit packing),使 padding 率最多不超过 $10^{-4}$。
(二)预训练设置
1. 模型设置
Transformer 总层数设置为 40、隐藏维度 $d$ 为 5120,模型采用因果编码器-解码器(CED)架构,Encoder 20 层、Decoder 20 层。前两层 Transformer 使用纯滑动窗口注意力(SWA)。Encoder 剩余 18 层采用 $m=2$ 压缩比例的 CSA2。这些层被划分为三组,每组 6 层。每组第一层为 Full Mode,后续五层为 Reuse Mode。Decoder 的 20 层全部使用 $m=1$ 压缩比例的 CSA2。Decoder 被划分为五组,每组 4 层。第一组:第一层 Full Mode,后续三层 Reuse Mode。剩余四组结构相同:第一层 Reindex Mode,后续三层 Reuse Mode。
所有 CSA2 层的配置如下:索引器 32 个 query head,每个索引器 head 的维度为 128。稀疏注意力选择 512 个 KV 条目。主注意力 query 64 个 head,每个 head 维度 512。query 压缩维度 1280。分层稀疏索引器(Hierarchical Sparse Indexer)最多选择 2048 个 block,每个 block 8 个位置。因此最大候选位置数量为 $2048\times8=16384$。输出投影分成 8 组,每组中间注意力输出维度 1024。SWA 窗口大小 $n_{\text{win} }=128$。所有 Transformer block 都采用 MoE 层。激活函数采用带截断限制的 SwiGLU,阈值为 10。每个 MoE 层包含 1 个共享专家,384 个路由专家。每个专家中间隐藏维度为 2304,每个 token 激活 6 个路由专家。mHC 扩展因子为 4,Sinkhorn-Knopp 迭代 20 次。
视觉编码器层数 32 层,隐藏维度 1024,注意力头 16,patch 大小 14。视觉 MLP 投影器两层,隐藏维度 5120。
在上述配置下,DeepSeek-V4.1-Flash Backbone 参数量 552B,prefill 阶段每 token 激活参数 8B,decode 阶段每 token 激活参数 16B。
2. 训练设置
线性变换参数使用 Muon 优化器,所有 RMSNorm 权重、其他非矩阵参数使用 AdamW 优化器。所有 embedding、prediction head 采用 Sinkhorn 平衡更新。对于 AdamW,将超参数设置为 $\beta_1 = 0.9$、$\beta_2=0.95$、$\epsilon=10^{-20}$、$\text{weight_decay}=0.1$。对于 Muon,将动量设置为 0.95,权重衰减设置为 0.1,将每个更新矩阵 RMS 缩放到 0.18,以便复用 AdamW 的学习率设置。对于 Sinkhorn-balance update,动量系数和学习率修正因子与 Muon 保持一致,并设置 $K=11$、$\tau=10^{-3}$、$\epsilon=10^{-20}$。此外,Engram 的学习率提高了 5 倍。
模型在 45T token 的多模态数据上训练。整个训练过程保持稳定,没有出现训练不稳定现象。训练 batch size 全程保持 1.006 M tokens。学习率在前 2000 步线性 warmup,随后保持在 $2.6\times10^{-4}$,直到达到 28T tokens。随后在 28T 到 40T token 之间使用余弦衰减至 $2.6\times10^{-5}$。最后在 40T 到 45T 之间保持该学习率。直接使用稀疏注意力机制从零训练模型,训练初期使用 64K 序列长度,然后在 34T 的时候扩展至 1M 序列长度。无辅助损失负载均衡对图像与文本 token 的偏置更新速度均为 0.001,同时保留损失权重 0.0001 的序列级平衡损失以防单序列内极端失衡。与 DeepSeek-V4 类似,预训练采用样本级注意力掩码。
视觉编码器训练。DeepSeek-ViT 在与语言模型结合之前单独训练。训练分为两个阶段:对比预训练、自回归微调。
对比预训练采用 SigLIP 中引入的 sigmoid 对比损失,在约 47B 个源自 alt-text 数据的图文对上进行优化。为了在海量数据中高效学习视觉表征,该阶段将最大输入分辨率限制在 224×224。尽管此阶段用更高分辨率会带来显著增益,但实验表明这些增益对最终模型贡献甚小。因为后续自回归阶段专门负责高分辨率外推,对比预训练阶段抬升分辨率会显著增加计算而整体提升有限。
自回归微调阶段,把视觉编码器接到一个 4B MoE LLM 上,在图像描述、alt text、图表、OCR 等数据集共 236B token 上进行 next token prediction 训练,旨在增强编码器建模细粒度视觉特征的能力。因此,将输入分辨率通过按比例缩放,约束在 544×544 至 1344×1344 像素。此阶段结束后丢弃 LLM,只保留优化好的视觉编码器进入后续预训练流程,并沿用同样的分辨率策略。
四、后训练
(一)后训练流程
在本次发布中,没有提出新的后训练算法。整体训练流程遵循标准范式,即 SFT 之后进行 RL 和 OPD,除了采用已有的成熟实践外,没有进行算法层面的修改。相反,工作重点几乎全部集中在模型所训练的内容上,而不是优化方式上:V4.1 投入了大规模的自动化流水线用于数据合成和环境构建。具体而言,该流水线包括:
(1)合成多样化、可验证的训练任务,同时生成对应的参考解答和奖励信号;
(2)程序化构建并扩展交互式智能体环境,使轨迹能够以较低成本被收集和评估;
(3)采用严格的数据过滤、去重和难度校准策略,以保证数据质量和课程平衡。
最终发现,在固定的普通优化流程下,系统性提升合成数据和环境的规模、多样性以及可验证性,是所观察到性能提升的本质来源。这一观察也反映出一个更普遍的经验:在当前阶段,后训练中对数据和环境流程进行工程优化所带来的边际收益,显著超过算法创新所带来的收益。
1. 大规模智能体任务合成
任务是智能体学习的基础驱动力。然而,构建高质量训练任务通常需要大量人工投入。模型已经开始展现自主构建训练任务的能力,但这种能力仍然远未完善。基于这一潜力,V4.1 投入大量工作增强模型的任务构造能力和质量验证能力。我们将每个任务形式化为一个三元组:(problem, environment, verification system),并从两个维度评估任务质量:难度:确保任务具有非平凡的挑战性;正确性(correctness):保证三个组成部分之间不存在关键缺陷。利用难度和正确性作为奖励信号,迭代训练模型以构造更优质的任务。同时,会监控 RL 任务的完整生命周期。当一个任务被用于新的 RL 训练时,产生的轨迹会提供新的证据,用于重新审查任务质量。基于这一统一框架,为通用智能体和编程智能体两类核心场景构建了专门的训练环境生产流程。
对于通用智能体,鼓励内部员工和外部合作伙伴将最新模型应用于日常工作流程,并在自愿情况下返回交互数据和反馈。根据返回数据中观察到的接口,构建了大量模拟工具,用于复现真实世界工具和系统的接口及行为,包括输入格式、输出结构、API schema、行为约束。这些工具覆盖常见 SaaS 和企业应用,也覆盖更加专业的业务后端系统。与此同时,大规模收集了内部员工提交的负面反馈和模型失败案例,并将其纳入流程,以生成基于真实工作流程的单轮和多轮智能体环境。通过重建相关工具上下文、用户交互模式以及失败条件,该流程能够系统性地回放失败案例,并针对观察到的模型弱点进行强化学习。
编程智能体训练环境来自两个来源:内部员工和外部合作伙伴产生的 coding agent 使用记录,其中筛选高复杂度任务或模型表现较差的任务,并根据轨迹进行去重;满足 star 数量阈值的公开 GitHub 仓库。环境构建由多个专门智能体协同完成。首先,一个智能体判断项目是否能够在容器中构建并完整运行,以及是否能够自动验证。如果满足条件,该智能体会:选择具体的代码轮次或提交作为任务起点;设计多个具有足够复杂度的实现方向;生成具体评测点,包括 fail-to-pass 和 pass-to-pass;生成构建报告,并根据需要从网络获取外部资源。随后,另一个智能体在隔离容器中完成依赖配置、初始工作目录设置、测试代码准备、任务描述生成。之后,该智能体执行自测试,删除可能泄露任务解决方案的信息,并将环境打包为新的镜像层。接下来,多个不同智能体尝试完成任务,一个独立的质量检查智能体会检查环境以及解决智能体产生的轨迹,包括:环境问题、事实错误、评测点与任务描述之间的不匹配、可攻击性风险。如果检查未通过,修复智能体会修复所有发现的问题,调整过于简单或困难的评测点,并重新进入验证流程。
通过这些流程,能够自动化、大规模生成正确、具有区分能力,并且长度和难度可控的 RL 训练数据。无论是通过真实工作流程重建通用智能体环境,还是通过精确构造编程任务环境,两类数据最终都会进入统一训练系统,在持续质量监控下推动模型能力迭代提升。
2. 合成任务上的强化学习
在合成任务上使用大规模异步强化学习,以提升模型性能,并塑造模型在复杂场景中的行为。V4.1 从两个维度扩展 RL 训练规模:训练计算量、scaffold 的数量。随着累计 RL step 增加,无论是在单个 scaffold 内扩展、联合训练同一 scaffold 的不同变体,还是跨异构 scaffold 进行扩展,模型性能都会持续提升。
对于跨不同 scaffold 的 RL 训练,将智能体 rollout 执行过程解耦为:agent sandbox、worker container。其中,sandbox 运行 scaffold 及其工具,而 worker 提供一个与 scaffold 无关的控制层,用于协调 rollout、将异构交互规范化为统一的轨迹格式,并与训练器通信。二者都运行在 DSec上,并位于可抢占 GPU 训练池之外,从而将长时间运行的 rollout 与细粒度训练调度过程分离。当训练器发生抢占时,rollout 执行过程可以被暂停并卸载,同时保留完整状态,以便后续恢复,并释放 CPU 和 GPU 资源。这种设计使不同 scaffold 上的 RL 训练能够稳定、高效运行,而无需修改底层算法。
为了将有效 RL 计算扩展到单次训练之外的,使用模型合并(model merging)技术重新初始化后续 RL 训练。具体而言,合并来自不同 scaffold 或不同配置训练过程中的 checkpoint,从而整合沿不同优化路径所获得的改进。这种方法能够进一步提升任务性能和 token 效率,为聚合并行 RL 计算、实现跨连续运行持续扩展提供了一种简单且实用的方法。
3. 大规模运行智能体:DSec
随着从 DeepSeek-V3 到 V4的过度,智能体训练环境数量和多样性的快速增长促使团队构建了 DeepSeek Elastic Compute(DSec)。DSec 是一个面向大规模智能体训练和评估的生产级沙箱平台。其初始设计旨在解决异构执行环境、可扩展镜像分发、多种隔离后端、高密度资源管理、命令轨迹记录、支持抢占安全恢复等问题。随着 V4.1 训练规模扩展到百万级并发沙箱实例,系统优化重点从单个环境执行效率转向大规模集群扩展、资源密度以及智能体异常行为控制。
4. RL 中可控的推理开销
除了模型架构和硬件方面的进步,输出 token 数量也是影响服务成本的重要因素,进而也是实际应用中成本与质量权衡的关键因素。因此,V4.1 在强化学习过程中引入一个标量 effort level $b$ 作为显式条件信号。该机制同时应用于单轮推理任务和多轮智能体任务。具体而言,在 system prompt 中加入如下指令:
Reasoning Effort: {effort} (range 1–100; higher values request more thorough reasoning)
其中 $b\in{1,\ldots,100}$ 表示请求的推理努力程度。对于每个训练 prompt $x$,在每个 effort level $b\in B$ 下采样 $M_b$ 个响应: \(\begin{equation} z_{b,j}\sim\pi_\theta(\cdot|x,b), \quad b\in B,\ j=1,\ldots,M_b \end{equation}\) 其中,$j$ 表示在 effort level $b$ 下采样得到的响应编号。具有相同 $(x,b)$ 的响应构成一个子组,在该子组内部,对奖励进行均值中心化,用于计算组相对优势。因此,不同 effort level 的响应不会直接进行比较。通过让长度项奖励与 $b$ 挂钩,模型就能在各子组内,自发的演化出与设定等级相匹配的推理行为。具体而言,向响应 $z_{b,j}$ 的奖励中加入长度惩罚项 $r^{len}_{b,j}$: \(\begin{equation} r^{len}_{b,j} = -\min \left\{ C_{\max}, k(b)\frac{\ell_{b,j} }{L_{norm} } \right\} \end{equation}\) 其中:
- $\ell_{b,j}$ 表示推理 token 数量;
- $L_{norm}$ 表示参考长度;
- $C_{\max}$ 限制单条轨迹能够受到的最大扣分。
token 惩罚系数随着请求的 effort 指数下降: \(\begin{equation} k(b)=k_0\exp \left( -\frac{b-b_{\min} }{\tau} \right), \quad \tau=\lambda \overline{\Delta b} \end{equation}\) 其中:
- $k_0$ 表示不同 effort level 下的基础惩罚系数;
- $b_{\min}$ 表示 $B$ 中的最小值;
- $\overline{\Delta b}$ 表示训练 effort level 之间的平均间隔;
- $\lambda$ 控制惩罚衰减速度。
当 $b$ 增大 $\tau$ 时,有 $k(b+\tau)=k(b)\cdot e^{-1}$,即惩罚系数会乘以 $e^{-1} \approx 0.368$。也就是说每当把努力程度 $b$ 提高 $\tau$ 个数值,模型每生成一个 token 所受的惩罚就会下降到原来的约 36.8%。参数 $k_0$ 控制缩短推理长度的整体压力,而较小的 $\tau$ 会使惩罚衰减更快,并倾向于在不同推理努力水平之间产生更大的行为差异。
(二)异步后训练基础设施
在大语言模型的强化学习采样阶段,rollout 过程中的长尾问题一直是训练效率的主要瓶颈。为了解决这一问题,V4.1 扩展了后训练基础设施,使其支持异步样本生成。该方法通过维持足够高的并发水平,显著缓解了 rollout 阶段的长尾问题。目前,异步训练已经应用于几乎所有 RL 和 OPD 任务中,并显著提升了 rollout 效率。
1. 整体流程
将 rollout 和训练过程部署在相同的物理设备上,并通过分时执行机制,从而避免手动调整两个阶段之间的资源分配。每个任务都会指定一个正在执行中的样本数量上限,系统会在 rollout 阶段持续维持该并发数量。
V4.1 评估了三种用于维持目标 rollout 并发度的调度粒度。最终采用的方法是样本级调度(sample-level dispatch):当新完成的样本数量达到下一个 prompt 所分配的 GRPO 分组大小时,无论这些完成样本来自哪些 group,系统都会立即调度该 prompt。这种方式能够在训练过程中持续保持稳定的 rollout 并发水平。
在确定这一调度策略之前,尝试了两种替代方案。第一种方案采用 batch 级调度。具体来说,在训练开始阶段额外调度多个 batch,并在每轮训练结束后补充一个完整 batch。然而,该方法导致训练指标出现严重震荡,说明 batch 级粒度过于粗糙。第二种方案采用 prompt 级调度。该方法规定每当一个 GRPO group 完成后,就调度一个新的 prompt。但实验发现,这种方式容易受到 GRPO group 内长尾样本的影响,使系统难以平滑维持目标 rollout 并发量。
当积累了足够数量的训练样本后,训练过程会抢占正在执行的 rollout。在训练过程中,采用拼接式路由回放:对于跨越多个 checkpoint 的样本,会拼接每个 rollout 片段中产生的 expert routing 信息,而不是丢弃这些信息并使用新的 checkpoint 重新计算 routing。
2. 缓解长度偏差和 Off-Policy 效应
异步生成虽然能够有效提升 rollout 效率,但也会引入两个可能降低训练质量的问题。第一个问题是长度分布偏差。特别是在训练早期阶段,由于较短序列通常更早完成,因此它们会占据初始训练 batch 的更大比例。第二个问题是不可避免地产生 off-policy samples,即部分或全部 token 由较早版本的 checkpoint 生成的样本。针对这两个问题,V4.1 采用了不同的处理策略。
为了解决长度偏差,采用两种机制。第一,dispatcher 可以针对不同数据集限制并发数量。该机制能够调节稳定状态训练 batch 中不同数据集的比例,通过控制输入样本来源间接缓解长度偏斜问题。第二,支持丢弃过早返回的短样本。该方法能够使训练逐渐过渡到稳定状态下的长度分布,并避免模型过拟合过短序列。
针对离策略问题,实现了另外两种机制。第一,通过调整控制样本调度和训练样本等待条件的逻辑,能够限制最大的 off-policy ratio,确保训练数据不会与当前模型产生过大的偏离。第二,在训练过程中,加入 loss masking 机制。该机制会消除过度陈旧 token 对损失的贡献,从而降低过期样本对梯度更新产生的不良影响。
3. 性能优化
在异步 RL 框架中,rollout 阶段会周期性地被中断,以切换到更新后的 policy checkpoint。我们的目标是让这一过程无感化:
- 中断过程应接近瞬时完成;
- 被中断的 rollout 应能够像从未停止一样继续执行。
为了快速停止 rollout,V4.1 支持 token 级中断:生成过程可以在任意 token 边界处停止。当收集到足够训练数据后,所有正在执行中的样本几乎可以立即停止,使系统无需等待即可进入训练阶段。为了在 checkpoint 切换过程中保留 rollout 进度,会在生成过程中以 token 粒度保存 rollout 状态,例如:KV cache、expert routing。当使用新的 checkpoint 恢复执行时,系统可以直接复用这些已经保存的状态。这样无需重新进行 prefill,被中断的样本能够从停止位置继续生成。由于该机制需要保存所有正在执行样本的状态,因此采用 sample-grained garbage collection。即每个样本完成后,立即释放该样本对应的状态资源。除了 checkpoint 切换之外,这套快速中断和无缝恢复机制还能够让训练任务及时响应集群调度中的抢占信号,而不会丢失训练进度,从而提升整体集群利用率。
4. 大规模 OPD
作为后训练的最后阶段,最终的全词表 OPD 任务使用来自所有领域的数据集进行训练,并使用超过 40 个教师模型。该阶段同样采用异步生成,以提升 rollout 效率。
由于不同领域的训练流程存在差异,每个领域最佳的教师模型可能来自模型开发过程中的不同阶段。此外,不同教师模型之间,以及教师模型与学生模型之间,可能存在架构差异。V4.1 的后训练基础设施能够适应这种训练设置:它支持数量几乎无限的、架构异构的教师模型进行全词表 OPD,并能够以极低成本在不同教师模型之间进行切换。
OPD 阶段还需要在训练过程中动态调整配置。会持续跟踪模型能力,并根据情况调整训练方案,包括:
- 数据集混合比例;
- 每个数据集的并发限制;
- 当前启用的教师模型。
在同步训练中,这类变化较容易处理,因为 rollout batch 可以提供明确的配置边界。然而,在异步训练环境下,不同配置下生成的样本可能同时处于执行状态。V4.1 的基础设施能够支持不同配置之间的一致切换,同时不会中断 rollout 或训练过程。
五、总结
本文围绕长上下文智能体场景中的核心瓶颈——KV Cache 存储与数据传输成本展开,通过模型架构、缓存压缩、训练系统和后训练基础设施的协同设计,构建了一个支持百万 token 上下文的多模态 MoE 模型。模型架构方面,论文提出 Causal Encoder-Decoder(CED),通过将 prefill 和 decode 阶段的计算解耦,使 prefill 每 token 激活参数降低到 8B;提出 Compressed Sparse Attention 2(CSA2),结合跨层 KV 复用、分层稀疏索引器和 FP4 KV Cache,将运行时 global KV Cache 压缩到每 token 890 bytes;同时通过 SWA Bounded Replay 降低持久化 KV Cache 存储需求。在训练与部署方面,论文介绍了支持 CSA2、视觉模型训练以及大规模智能体运行的基础设施,包括大规模沙箱平台 DSec 和异步后训练系统。在后训练阶段,论文重点探索大规模任务合成、智能体环境构建、强化学习扩展以及可控推理长度训练。整体而言,DeepSeek-V4.1-Flash 围绕长上下文 agent 应用,将模型架构设计、KV Cache 压缩、低精度存储、训练基础设施和 RL 数据环境进行系统级联合优化,在降低部署成本的同时保持较强的推理和智能体能力。